

Leia este artigo em inglês.
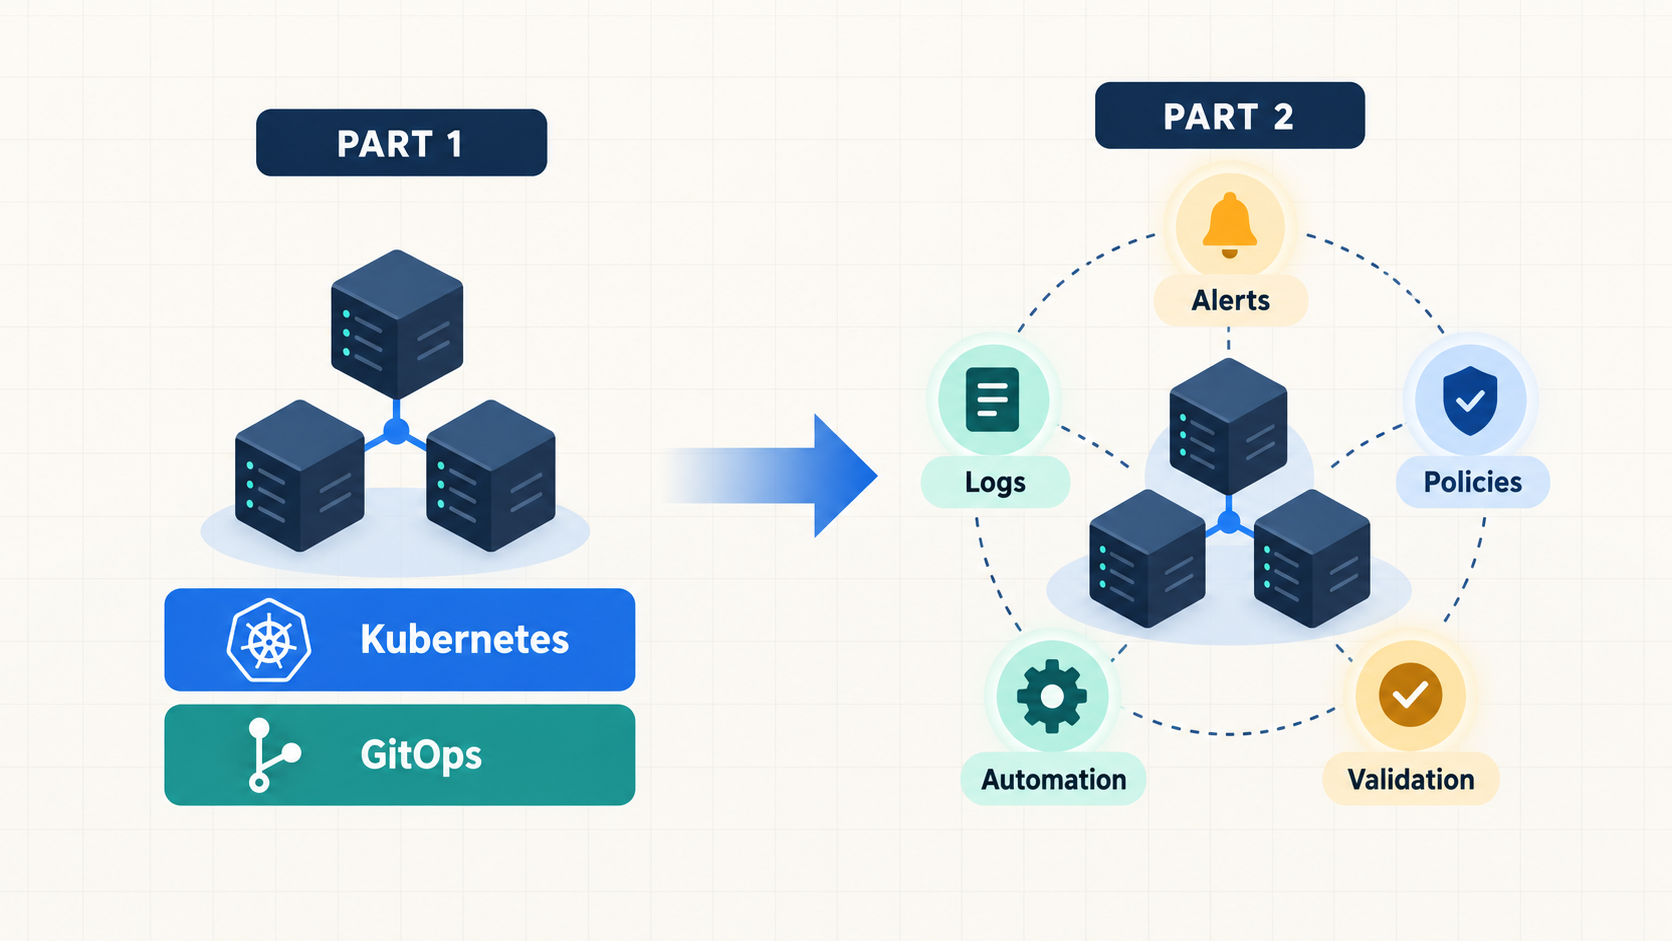
Este artigo é a continuação de HomeLab na OCI Free Tier. Na primeira parte, contei como construí o cluster. Agora é hora de falar sobre o que aconteceu depois que ele começou a ser usado de verdade.
Existe uma diferença enorme entre montar um cluster Kubernetes e operar uma plataforma.
Na primeira parte desta série, meu HomeLab na OCI já parecia bastante completo. OKE com nós ARM64, Argo CD gerenciando tudo via GitOps, Istio em Ambient Mode, Keycloak centralizando autenticação, External Secrets integrado ao Bitwarden e uma stack de observabilidade com Prometheus, Grafana e Kiali. Era o tipo de arquitetura que fica bonita em um diagrama.
Então fiz o que qualquer pessoa faria ao perceber que seu laboratório estava estável: coloquei mais coisas nele. O Outline foi migrado para o Kubernetes. O Renovate começou a abrir atualizações automaticamente. Loki e Promtail passaram a centralizar logs. Kyverno começou a avaliar políticas. Falco passou a observar comportamento em runtime. O Istio Gateway começou a registrar o tráfego público. Novos dashboards apareceram. Mais serviços ganharam SSO.
E, naturalmente, apareceram novas formas de tudo dar errado.
Esta não é uma lista de ferramentas instaladas desde o primeiro artigo. É a história de como cada necessidade, falha e investigação deixou alguma melhoria permanente no repositório e de como transformei o HomeLab, que era apenas um cluster funcional, em uma pequena plataforma.
Resumo rápido
Nos meses seguintes à Parte 1, o HomeLab cresceu, quebrou e começou a ensinar. Atualizações automatizadas, alertas mais inteligentes, políticas de segurança e experimentos que nem sempre saíram como esperado transformaram um cluster funcional em uma plataforma mais operável.
O que você vai encontrar
- como o Renovate mudou o ritmo de evolução do repositório;
- por que adotar Cilium no OKE exigia mais do que instalar um chart;
- a migração do Outline e a expansão da observabilidade;
- alertas acionáveis, análise de scanners, Kyverno e Falco;
- o problema com o certificado que levou ao Reloader e ao metrics-server;
- validações GitOps e uma integração read-only entre Argo CD e Codex.
O roadmap começou a se mover
No final da Parte 1, o Renovate aparecia na seção “What's Next”. Manter versões de charts, imagens e actions manualmente ainda era uma tarefa recorrente. Ou, sendo honesto, uma tarefa que eu lembrava de fazer de vez em quando.
Esse foi um dos primeiros débitos a sair da lista.
O Renovate passou a acompanhar charts Helm, imagens de containers, GitHub Actions, dependências Python, providers Terraform e até versões do Kubernetes. Em poucos meses, o histórico do repositório começou a mostrar uma coisa que eu dificilmente manteria sozinho: atualizações pequenas, frequentes e rastreáveis.
Argo CD avançou por várias versões. O kube-prometheus-stack também. Istio, cert-manager, External Secrets, Keycloak, Kyverno, Loki, Ghost e Outline foram atualizados continuamente. Dependências deixaram de envelhecer silenciosamente.
Automação não elimina trabalho; ela muda o tipo de trabalho.
Em vez de procurar versões novas, passei a analisar mudanças, validar manifests e corrigir incompatibilidades introduzidas por upgrades. Isso ficou evidente quando uma atualização do kube-prometheus-stack mudou o comportamento dos ServiceMonitors do control plane e quebrou a renderização do Application usado somente para instalar CRDs.
A solução não foi desativar o Renovate. Foi melhorar a separação de responsabilidades: o release de CRDs passou a renderizar apenas CRDs, sem regras, exporters ou ServiceMonitors que dependiam de um Prometheus habilitado.
Essa virou uma regra importante para mim: a automação pode encontrar o problema mais rápido, mas eu ainda preciso expressar claramente a arquitetura no repositório.
Quando o Cilium encontrou os limites da arquitetura
Nem toda evolução termina com uma ferramenta nova rodando no cluster.
Em abril, comecei a avaliar o Cilium como uma possível evolução da rede do HomeLab. A ideia fazia sentido: usar eBPF para políticas e load balancing e ganhar o Hubble para observar o tráfego de rede.
A proposta usava Cilium 1.17.2, IPAM em cluster-pool, uma rede overlay com VXLAN, MTU ajustado para a OCI e integração com CRI-O e Istio CNI. Durante a validação, porém, ficou claro que não se tratava de uma simples instalação de chart. O cluster OKE havia sido criado com OCI_VCN_IP_NATIVE.
Nesse modelo, o plugin da Oracle entrega aos pods endereços diretamente da VCN e participa da criação das interfaces de rede. Ao tratar o Cilium como substituto, com IPAM e overlay próprios, dois sistemas poderiam assumir partes diferentes da rede dos pods.
Em um cluster gerenciado e já ocupado, um erro nessa camada poderia afetar todas as aplicações e impedir que novos pods tivessem rede suficiente até para executar a correção. A decisão foi interromper a mudança e reverter os manifests.
Na época, associei parte da limitação ao ambiente enxuto do Free Tier. O problema principal, porém, era arquitetural: substituir o CNI VCN-native de um OKE existente exigia muito mais planejamento do que instalar Cilium pelo Argo CD. Hoje o projeto documenta um modo de chaining específico para esse cenário, mantendo o OCI CNI responsável por interfaces e endereços enquanto o Cilium acrescenta eBPF, políticas e visibilidade.
O Cilium não entrou no cluster naquela etapa, e isso também fez parte da evolução do HomeLab. O laboratório permitiu testar a hipótese, identificar o risco e registrar um caminho mais seguro para um experimento futuro.
O que estava fora entrou no cluster
Na Parte 1, o Outline ainda estava em transição. A aplicação rodava em Docker Compose, compartilhando uma VM com PostgreSQL, Redis e MinIO.
A migração para Kubernetes finalmente aconteceu.
O Outline ganhou um chart próprio, recursos declarativos, integração com Istio, autenticação pelo Keycloak e Secrets sincronizados pelo External Secrets. WebSockets exigiram ajustes específicos de rota e timeout. O acesso ao MinIO precisou de configuração path-style. URLs externas e redirects OIDC tiveram de ser corrigidos até toda a cadeia concordar que o serviço realmente estava em HTTPS.
Nenhuma dessas mudanças, isoladamente, é muito dramática. Juntas, porém, mostram a diferença entre “subir um container” e integrar uma aplicação a uma plataforma.
A aplicação precisava conversar com identidade, rede, storage, observabilidade e gerenciamento de Secrets. Quando finalmente entrou no cluster, não foi apenas uma mudança de runtime. Ela passou a participar do mesmo modelo operacional dos demais serviços.
Dashboards não chamam ninguém
Prometheus, Grafana e Kiali já existiam desde a primeira versão do HomeLab. Eu tinha métricas, gráficos e topologia da malha. Tecnicamente, havia observabilidade.
Na prática, ela ainda dependia de alguém abrir uma tela e perceber que algo estava estranho.
Esse modelo funcionava enquanto eu estava olhando para o laboratório. O problema era simples: eu não passava o dia observando dashboards do meu HomeLab, e nem deveria.
A stack evoluiu em duas direções.
A primeira foi ampliar a coleta. ServiceMonitors foram adicionados para Argo CD, cert-manager, Kyverno, External Secrets, ExternalDNS, Keycloak e Kiali. Loki e Promtail entraram para centralizar logs, usando o MinIO como storage S3. Os access logs do Istio Gateway passaram por pipelines específicos para extrair host, status, origem e destino.
A segunda foi transformar dados em sinais acionáveis. O Grafana Alerting passou a centralizar regras e enviar notificações por e-mail. Alertas básicos foram revisados para reduzir ruído: contar reinícios não era suficiente para identificar CrashLoopBackOff, e olhar apenas para pods em Pending não encontrava pods Running que nunca ficavam Ready.
Também surgiram alertas que tentam olhar um pouco adiante:
- CPU sustentada alta, ignorando picos curtos;
- PVCs com menos de 10% de espaço;
- aplicações do Argo CD degradadas ou fora de sincronização;
- certificados próximos da expiração;
- eventos críticos do Falco e bloqueios do Kyverno.
Os alertas críticos passaram a ter espera menor e repetição mais frequente. Warnings ganharam mais tolerância. O objetivo deixou de ser “avisar sobre tudo” e passou a ser “avisar quando existe alguma coisa que vale interromper o que estou fazendo”.
A internet eventualmente encontra tudo
Assim que publiquei os primeiros endpoints, os scanners começaram a bater neles. Não importava se era um blog pessoal, uma página de login ou um serviço recém-publicado. A internet encontrou todos.
Os access logs do Istio Gateway deixaram isso bastante visível: tentativas de acessar arquivos .env, diretórios Git, painéis administrativos, endpoints de frameworks, arquivos de backup e caminhos conhecidos de vulnerabilidades apareciam regularmente.
Na análise mais recente, consultei 15 dias de tráfego de todos os hosts públicos. O script avaliou 49.974 entradas e separou 3.267 acessos a caminhos sensíveis e outros 1.253 acessos suspeitos para revisão. Esses números não significam que dados foram expostos. Muitas respostas eram redirects ou fallbacks das aplicações, mas o volume deixou claro por que a borda precisava aprender com o próprio tráfego.
GET /.env HTTP/1.1 403 rbac_access_denied_matched_policy[policy[block-scanner-probes]-rule[0]] host=blog.gabrielandre.com.br
GET /.git/config HTTP/1.1 403 rbac_access_denied_matched_policy[policy[block-scanner-probes]-rule[0]] host=dashboard.gabrielandre.com.br
GET /wp-json/gravitysmtp/v1/tests/mock-data HTTP/1.1 403 rbac_access_denied_matched_policy[policy[block-scanner-probes]-rule[0]] host=blog.gabrielandre.com.br
GET / HTTP/1.1 403 rbac_access_denied_matched_policy[policy[block-scanner-probes]-rule[1]] user-agent="Mozilla/5.0 zgrab/0.x"
Os bloqueios aparecem como respostas 403 geradas pelo AuthorizationPolicy antes de a requisição chegar à aplicação. A regra 0 cobre paths sensíveis; a regra 1 bloqueia user agents conhecidos de scanners. Atualmente, o chart mantém 81 padrões de paths e quatro padrões de user agent. A configuração declarada no repositório é esta:
Ver a configuração completa de bloqueio do gateway
security:
  blockScanners:
    enabled: true
    name: block-scanner-probes
    paths:
    - "/.aws*"
    - "/.docker*"
    - "/.env*"
    - "/.git*"
    - "/.npmrc"
    - "/.pypirc"
    - "/.ssh*"
    - "/actuator*"
    - "/adminer*"
    - "/api/actuator*"
    - "/api/.env*"
    - "/app/.env*"
    - "/app/actuator*"
    - "/appsettings*.json"
    - "/backend/actuator*"
    - "/backend/.env*"
    - "/boaform*"
    - "/cgi-bin*"
    - "/config*.json"
    - "/credentials*.json"
    - "/firebase*.json"
    - "/gcp-credentials*.json"
    - "/google-credentials*.json"
    - "/service-account*.json"
    - "/phpinfo.php"
    - "/phpmyadmin*"
    - "/config.php"
    - "/secret*"
    - "/secrets*.json"
    - "*/application.properties"
    - "*/application.yaml"
    - "*/application.yml"
    - "*/config.env"
    - "*/credentials.json"
    - "*/docker-compose.yaml"
    - "*/docker-compose.yml"
    - "*/secret.json"
    - "*/secret.yaml"
    - "*/secret.yml"
    - "*/secrets.json"
    - "*/secrets.yaml"
    - "*/secrets.yml"
    - "*/settings.py"
    - "*/terraform.tfstate"
    - "*/terraform.tfvars"
    - "*/wlwmanifest.xml"
    - "*credentials.json"
    - "*firebase-service-account*.json"
    - "*gcp-service-account*.json"
    - "*google-service-account*.json"
    - "*keyfile*.json"
    - "*service-account*.json"
    - "*service-account-key*.json"
    - "*secret.json"
    - "*secrets.json"
    - "*.properties"
    - "*.yaml"
    - "*.yml"
    - "/internal/actuator*"
    - "/server/actuator*"
    - "/vendor/phpunit*"
    - "/v1/actuator*"
    - "/v2/actuator*"
    - "/wordpress*"
    - "/wp-*"
    - "/wp/*"
    - "/wp-content*"
    - "/wp-includes*"
    - "/xmlrpc.php"
    - "*.php"
    - "*/.git*"
    - "*/.env*"
    - "*/.aws*"
    - "*/.ssh*"
    - "*/.docker*"
    - "*/.npmrc"
    - "*/.pypirc"
    - "*/wp-includes*"
    - "*/wp-admin*"
    - "*/wp-content*"
    - "*/xmlrpc.php"
    userAgents:
    - "TLM-Audit-Scanner/1.0"
    - "libredtail-http"
    - "Mozilla/5.0 zgrab/0.x"
    - "Mozilla/5.0 (compatible; CMS-Checker/1.0; +https://example.com)"
A mesma análise sugeriu 14 padrões de AuthorizationPolicy. Todos já estavam cobertos pela configuração atual, então nenhuma regra duplicada precisou entrar no chart. Esse resultado também faz parte do fluxo: analisar não significa necessariamente mudar.
Em vez de adicionar bloqueios manualmente depois de olhar algumas linhas de log, nasceu um fluxo repetível. Um script consulta o histórico no Loki, analisa todos os hosts públicos, identifica padrões sensíveis e compara as sugestões com os caminhos já bloqueados pelo AuthorizationPolicy do gateway.
Se um caminho novo aparece, ele vira uma mudança declarativa no chart. Se já está coberto, nenhuma regra duplicada é criada.
O interessante não é a lista de scanners bloqueados. É o ciclo que surgiu:
tráfego real → logs → análise → mudança no Git → validação → Argo CDO laboratório passou a aprender com o próprio tráfego.
Segurança em mais de uma camada
Bloquear probes no gateway protege a borda, mas não responde ao que acontece dentro do cluster.
Kyverno entrou para transformar convenções em políticas. Containers privilegiados, namespaces do host, imagens com tag latest, ausência de labels e falta de limites de recursos deixaram de ser apenas itens de documentação. Primeiro, as regras chegaram em modo audit, permitindo observar o impacto antes de bloquear workloads.
Falco acrescentou outra perspectiva: comportamento em runtime. Em vez de perguntar apenas “este manifest deveria ser aceito?”, ele ajuda a perguntar “o que este processo está fazendo depois que iniciou?”. Eventos seguem pelo Falcosidekick, chegam ao Loki e também alimentam métricas e alertas no Grafana.
Não transformei o HomeLab em um SOC. A ideia foi mais simples: experimentar como políticas de admissão, detecção em runtime, logs e alertas se complementavam e descobrir quanto disso cabia em duas máquinas ARM do Free Tier.
O certificado renovou, e mesmo assim tudo parou
A melhoria mais recente começou com um problema que parecia contraditório.
Os ExternalSecrets não estavam sincronizando. O ClusterSecretStore apontava erro ao buscar dados no provider do Bitwarden. A primeira suspeita natural era credencial, conectividade ou alguma mudança na API.
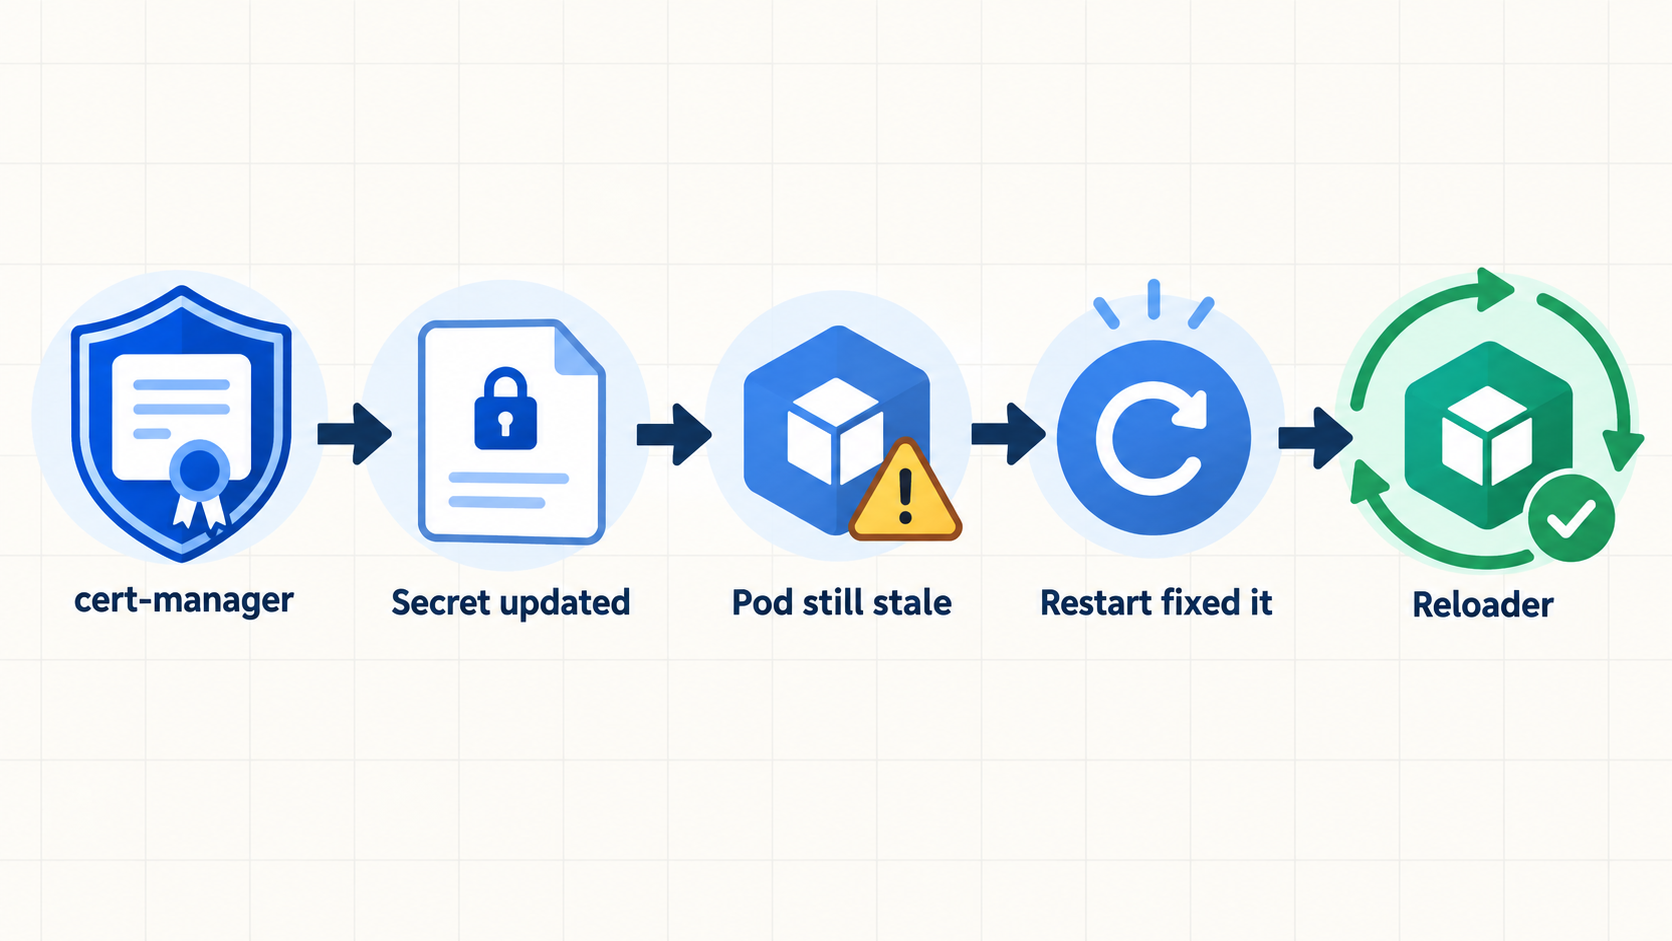
O cert-manager, porém, mostrava que o certificado do Bitwarden SDK estava válido. Ele havia sido renovado corretamente, estava dentro da validade e o Secret Kubernetes continha o novo certificado. Mesmo assim, o serviço não funcionava.
A pista apareceu ao comparar datas: o certificado havia sido renovado em agosto, mas o pod do Bitwarden SDK estava rodando havia 46 dias. O Secret montado no volume tinha sido atualizado; o processo, não.
O cert-manager cumpriu seu trabalho. O Kubernetes atualizou o Secret. Mas ninguém reiniciou a aplicação para que ela carregasse o novo material TLS.
Um rollout restart resolveu o problema imediatamente. O ClusterSecretStore voltou a ficar Ready e, depois de forçar uma reconciliação, todos os ExternalSecrets voltaram a sincronizar. Mas reiniciar manualmente o pod resolveria apenas aquela noite.
A correção permanente foi adicionar o Reloader ao GitOps e anotar explicitamente o Deployment do Bitwarden SDK para observar o Secret TLS. Nas próximas renovações, uma mudança no Secret provocará um rollout automático.
A investigação também levou a uma revisão maior da cadeia de certificados. Issuers e certificados foram organizados no namespace correto, a CA foi separada do certificado de serviço e sync waves passaram a expressar a ordem entre cert-manager, emissão dos certificados, External Secrets, ClusterSecretStore e os ExternalSecrets gerenciados.
Foi um bom lembrete de que “certificado renovado” e “aplicação usando o certificado renovado” são duas condições diferentes.
Um problema revelou outro
Durante a mesma investigação, outro sintoma apareceu:
failed to get cpu utilization: unable to fetch metrics from resource metrics API:
the server could not find the requested resource (get pods.metrics.k8s.io)
O cluster tinha Prometheus, node-exporter e kube-state-metrics, mas não tinha metrics-server. São peças diferentes: Prometheus coleta e armazena métricas para observabilidade; o metrics-server fornece a Resource Metrics API utilizada por comandos como kubectl top e por mecanismos de autoscaling.
O metrics-server entrou como mais um Application gerenciado pelo Argo CD, com configuração adequada para acessar os kubelets do OKE.
À primeira vista, o problema do certificado e o erro da Metrics API pareciam assuntos separados. No fim, ambos apontavam para a mesma coisa: o cluster já não precisava apenas de novos componentes; precisava de um modo mais consistente de ser operado.
Operando o laboratório por uma interface nova
Uma das mudanças mais importantes não foi um novo controller dentro do cluster, mas uma nova forma de conversar com ele.
A mudança começou pelo próprio repositório. Overlays Kustomize passaram a ser renderizados, charts Helm locais passaram a ser testados, manifests ganharam validação de schema com kubeconform e o Gitleaks passou a verificar o histórico e o conteúdo antes de commits e pushes.
Com o Git funcionando como interface de mudança, faltava uma forma segura de consultar a plataforma sem abrir mão desse fluxo.
O Argo CD ganhou uma conta local dedicada chamada mcp, com capacidade de gerar tokens e RBAC somente leitura.
Essa conta alimenta um servidor MCP do Argo CD usado pelo Codex. A integração consegue listar Applications, consultar estados de sincronização e ajudar em investigações sem receber permissão para alterar o cluster.
O detalhe mais importante foi justamente o limite. A ferramenta de IA não precisava começar com acesso administrativo para ser útil. A leitura de estado, logs, métricas e manifests já oferecia contexto suficiente para grande parte do trabalho de diagnóstico. Quando uma alteração é necessária, ela continua acontecendo no repositório e passando pelo mesmo fluxo de revisão e validação.
É menos “uma IA controlando meu cluster” e mais “uma interface adicional para entender uma plataforma declarativa”.
O que realmente mudou
Comparando o ambiente atual com aquele da Parte 1, a diferença não está apenas na quantidade de componentes.
- Eu tinha métricas. Agora existem alertas que tentam separar sintomas transitórios de problemas acionáveis.
- Os certificados eram renovados automaticamente. Agora os workloads que os consomem também reagem à renovação.
- A internet deixava rastros nos logs. Agora esses rastros alimentam análise e políticas no gateway.
- As versões eram atualizadas quando eu lembrava. Agora o Renovate mantém um fluxo constante de mudanças pequenas.
- O repositório descrevia o cluster. Depois dessas mudanças, ele também passou a validar, proteger e explicar como o cluster deveria evoluir.
Nada disso tornou o HomeLab infalível. Ele ainda poderá quebrar, especialmente porque continuará mudando. A diferença é que as próximas falhas terão mais chance de ser percebidas, explicadas e transformadas em melhorias permanentes.
Construir foi só o começo
A primeira versão do HomeLab respondeu à pergunta: “dá para rodar uma stack cloud-native completa no Free Tier da OCI?”.
A resposta continua sendo sim.
Mas estes meses trouxeram uma pergunta mais interessante: “dá para operar isso de uma forma que não dependa de memória, sorte e comandos manuais?”.
Ainda não existe uma resposta definitiva. O laboratório continua sendo um laboratório. Existem débitos técnicos, escolhas que eu provavelmente faria diferente e várias ideias esperando sua vez.
Mesmo assim, a maior mudança já aconteceu. O HomeLab deixou de ser apenas um conjunto de ferramentas interessantes rodando em Kubernetes. Ele ganhou ciclos de feedback: observar, alertar, investigar, corrigir no Git, validar e aprender com cada falha.
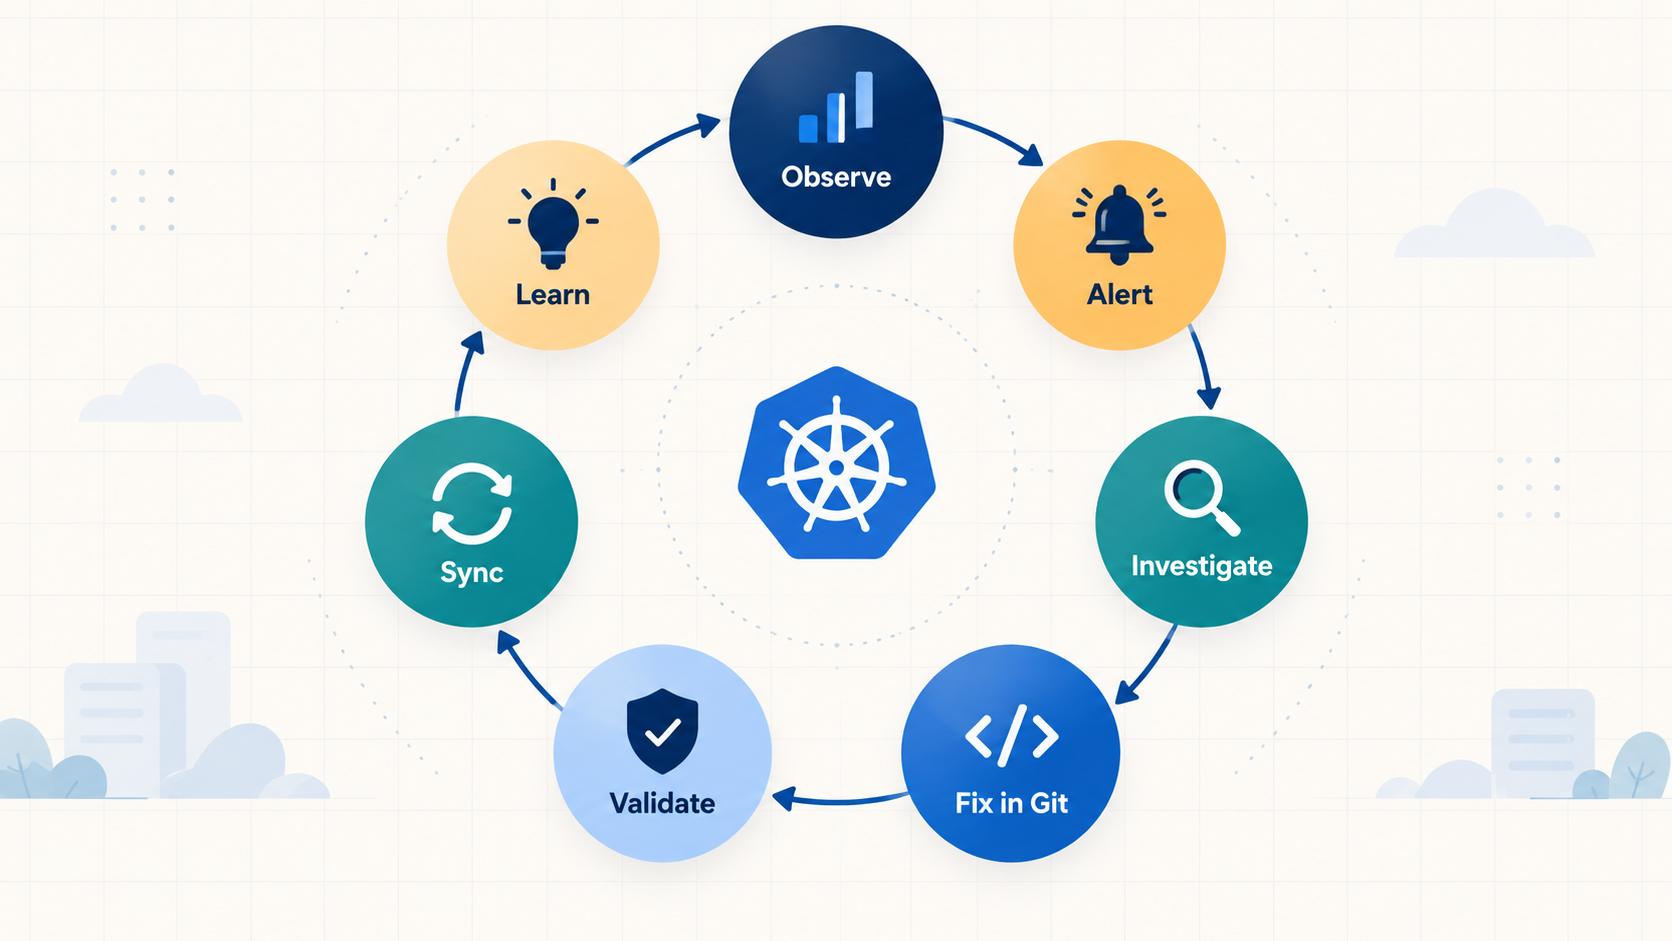
Construir o cluster foi a parte visível. Transformá-lo em uma plataforma aconteceu depois, uma falha, uma investigação e um commit por vez.
Links
Infraestrutura e GitOps
- HomeLab na OCI Free Tier, Parte 1
- OCI Free Tier
- Oracle Kubernetes Engine
- Kubernetes
- Terraform
- Renovate
- Argo CD
- Istio Ambient Mode
- Cilium e Hubble
Identidade e segurança
Observabilidade
Aplicações e ferramentas
💡 Quem sou eu?
Sou Gabriel Carmo, CNCF Kubestronaut, com certificações CKA, CKAD, CKS, KCNA e KCSA, além de Red Hat Certified OpenShift Administrator.
Atuo em DevOps Engineering, construindo e evoluindo plataformas Kubernetes multi-cloud. Meu trabalho tem como foco reduzir a carga cognitiva das equipes de engenharia por meio de platform engineering, automação, GitOps e experiências self-service.
No dia a dia, conecto infraestrutura como código, cloud networking, governança, segurança, observabilidade e práticas de SRE para criar plataformas mais padronizadas, resilientes e fáceis de operar.