

Read this article in English.
Existe um momento pelo qual quase todo profissional de infraestrutura passa. Você abre a fatura da nuvem, encara um valor difícil de justificar para um projeto pessoal e pensa: “deve existir uma forma melhor”. Foi exatamente o que aconteceu comigo.
Eu queria um ambiente onde pudesse executar ferramentas próximas das usadas em produção, experimentar novos padrões e hospedar meus próprios serviços sem carregar uma fatura de AWS ou GCP. Resolvi levar a sério o Always Free da Oracle Cloud Infrastructure. Dois anos depois, o ambiente continuava funcionando e havia superado minhas expectativas.
Este não é um tutorial passo a passo. É a história de um HomeLab construído gradualmente durante dois anos na OCI, moldado por uso real, falhas reais e pelas tecnologias que eu precisava aprender ao longo do caminho.
Resumo rápido
Duas VMs ARM64 no Free Tier da OCI se tornaram um cluster OKE com GitOps, service mesh, identidade, Secrets externos, observabilidade e aplicações reais. O custo financeiro permaneceu próximo de zero; o aprendizado, definitivamente, não.
O que você vai encontrar
- infraestrutura do OKE provisionada com Terraform;
- GitOps com Argo CD e o padrão App of Apps;
- Istio em Ambient Mode para economizar recursos;
- TLS, SSO e Secrets fora do Git;
- observabilidade com Prometheus, Grafana e Kiali;
- Ghost, Outline e automações do repositório.
Por que OCI e o que “Always Free” realmente significa
Quase todo provedor oferece algum tipo de free tier. Normalmente ele expira depois de alguns meses ou é limitado a ponto de servir apenas para tutoriais. O Always Free da OCI era diferente: não tinha prazo de expiração e entregava recursos suficientes para manter workloads reais. Para Kubernetes, o destaque era a família Ampere A1, baseada em ARM64.
- 4 OCPUs e 24 GB de RAM distribuídos entre instâncias Ampere A1
- 200 GB de block storage
- 10 TB de transferência de saída por mês
Essa capacidade era suficiente para executar observabilidade, service mesh, identidade, runners de CI/CD e aplicações ao mesmo tempo. A principal condição era usar imagens compatíveis com ARM64. Algumas imagens antigas publicavam apenas builds amd64, mas o ecossistema cloud-native moderno já oferecia amplo suporte multiarch. Na prática, isso raramente foi um problema.
Provisionando o cluster com Terraform
O cluster rodava no Oracle Kubernetes Engine (OKE), o Kubernetes gerenciado da OCI. A Oracle administrava o control plane sem custo adicional, inclusive no Free Tier.
Desde o primeiro dia, toda a infraestrutura foi provisionada com Terraform. Nada de construir redes ou clusters clicando no console. O código declarava os componentes essenciais:
- VCN com sub-redes públicas e privadas
- Cluster OKE com control plane gerenciado
- Node pool com duas VM.Standard.A1.Flex, cada uma com 2 OCPUs, 12 GB de RAM e arquitetura ARM64
Isso importava porque laboratórios são desmontados, reconstruídos e usados para testar upgrades arriscados. Quando algo quebrava a ponto de recomeçar ser a melhor opção, toda a infraestrutura podia ser recriada com terraform apply. Essa previsibilidade valia muito.
Você pode usar este repositório como base para criar seu próprio cluster: https://github.com/nce/oci-free-cloud-k8s. Usei-o como ponto de partida para minha própria infraestrutura.
GitOps com Argo CD: tudo nasce no Git
Com o cluster pronto, surgiu a próxima pergunta: como administrar tudo o que rodaria nele? A resposta foi GitOps com Argo CD.
Nada era instalado manualmente. Applications, valores de charts Helm e recursos Kubernetes eram declarados no Git e reconciliados pelo Argo CD. Se não estava no repositório, não deveria existir no cluster.
O padrão App of Apps
O bootstrap começava com uma única aplicação raiz, a root-app. Ela apontava para outras Applications e ApplicationSets, que gerenciavam todo o restante. Esse é o padrão App of Apps: o Argo CD administra declarativamente até a própria configuração.
root-app
├── bootstrap-infrastructure   → namespaces
├── bootstrap-istio            → istio-base, istiod, ztunnel, cni, ingress
├── bootstrap-security         → cert-manager, keycloak, external-secrets
├── bootstrap-observability    → prometheus, grafana, kiali
├── bootstrap-cicd             → argocd (self-managed), github-runner
└── bootstrap-apps             → ghost, outline-wiki
Inicializar o cluster inteiro exigia apenas um comando:
kubectl apply -f argocd/root-apps/root-app.yaml
Depois do primeiro apply, o Argo CD assumia o controle e começava a gerenciar a si próprio. A root-app implantava cada grupo de aplicações de forma independente. Algumas eram experimentos; outras formavam a base da plataforma.
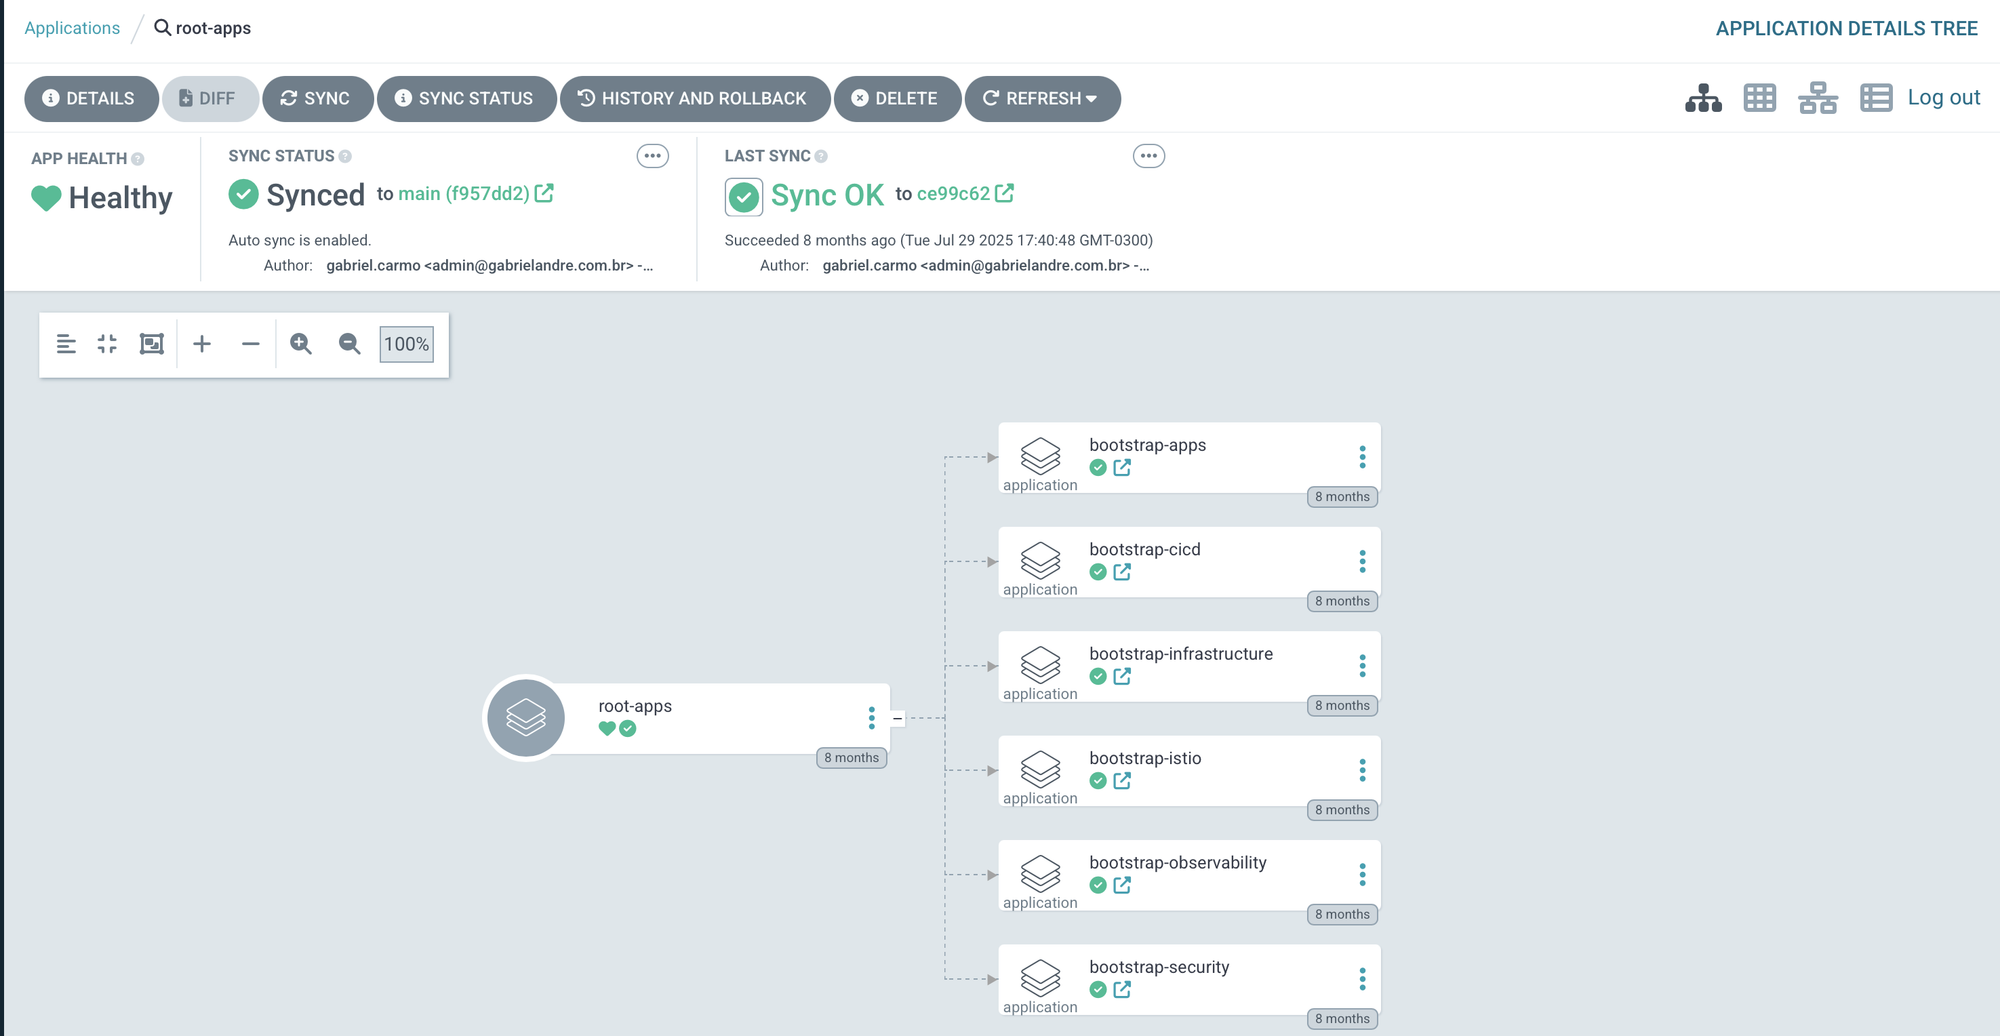
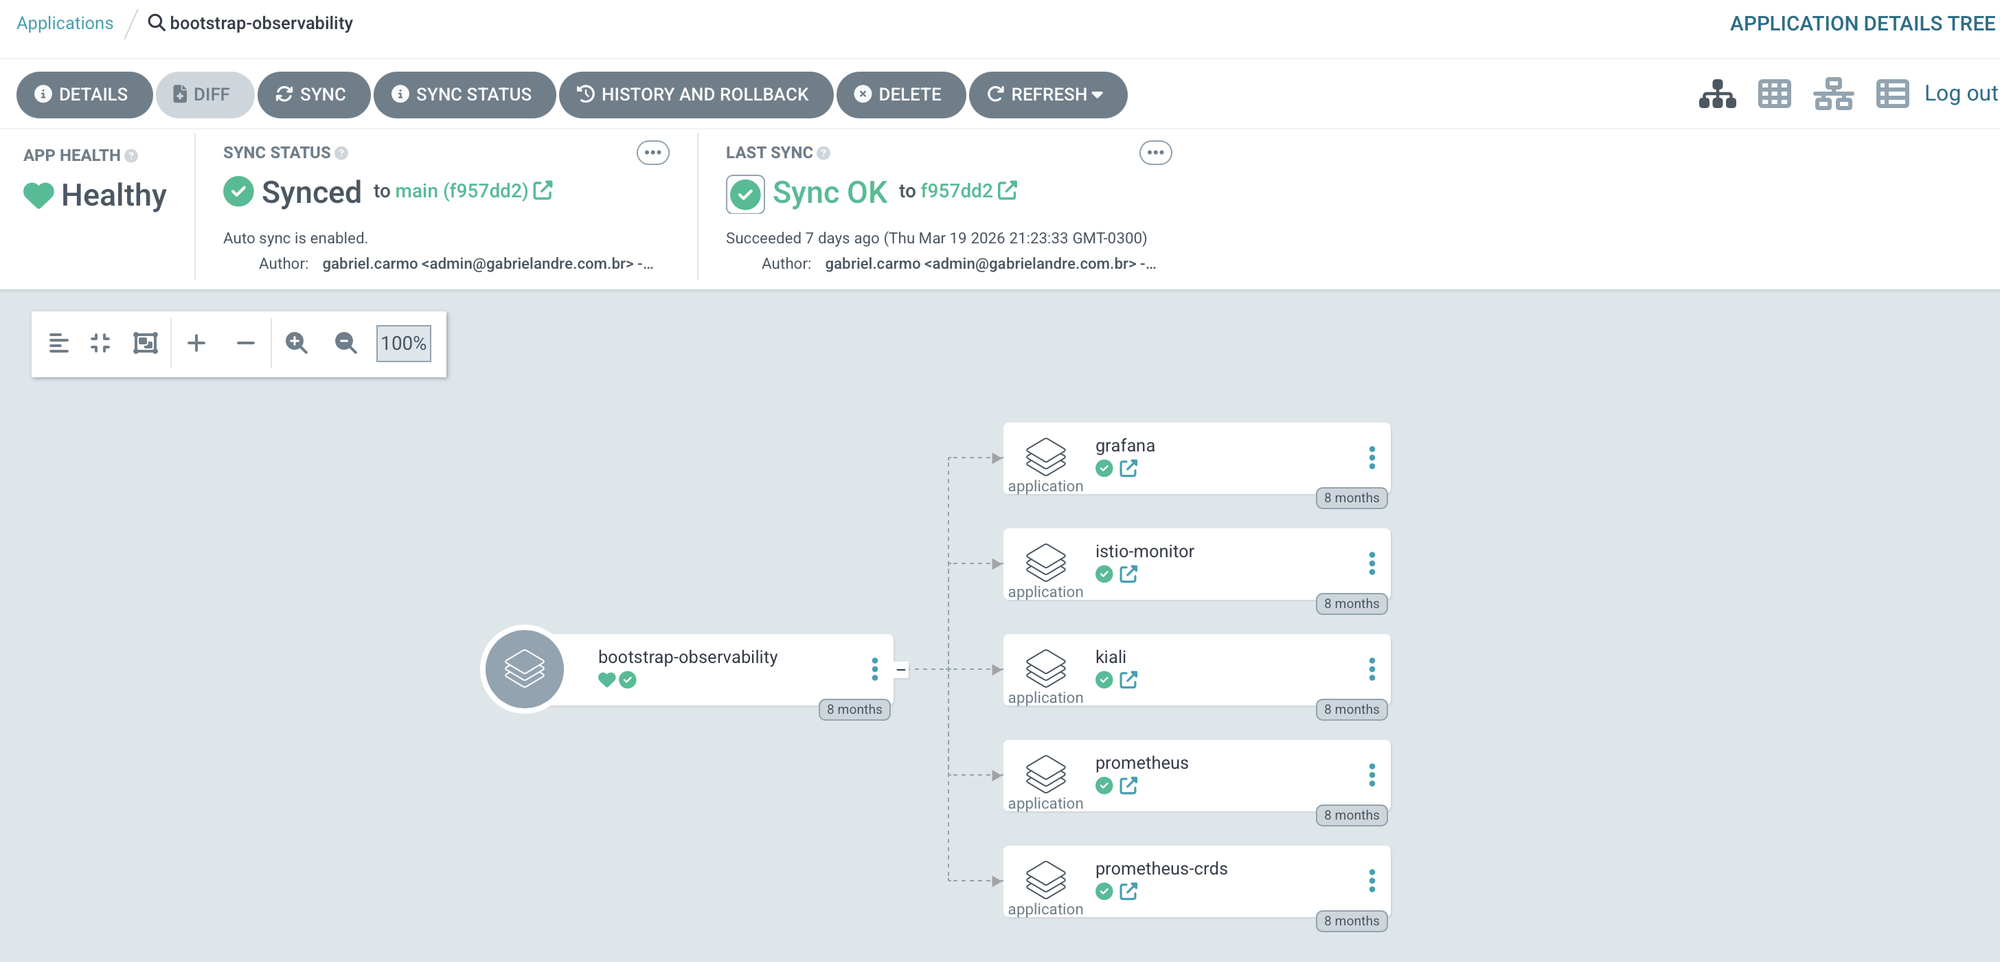
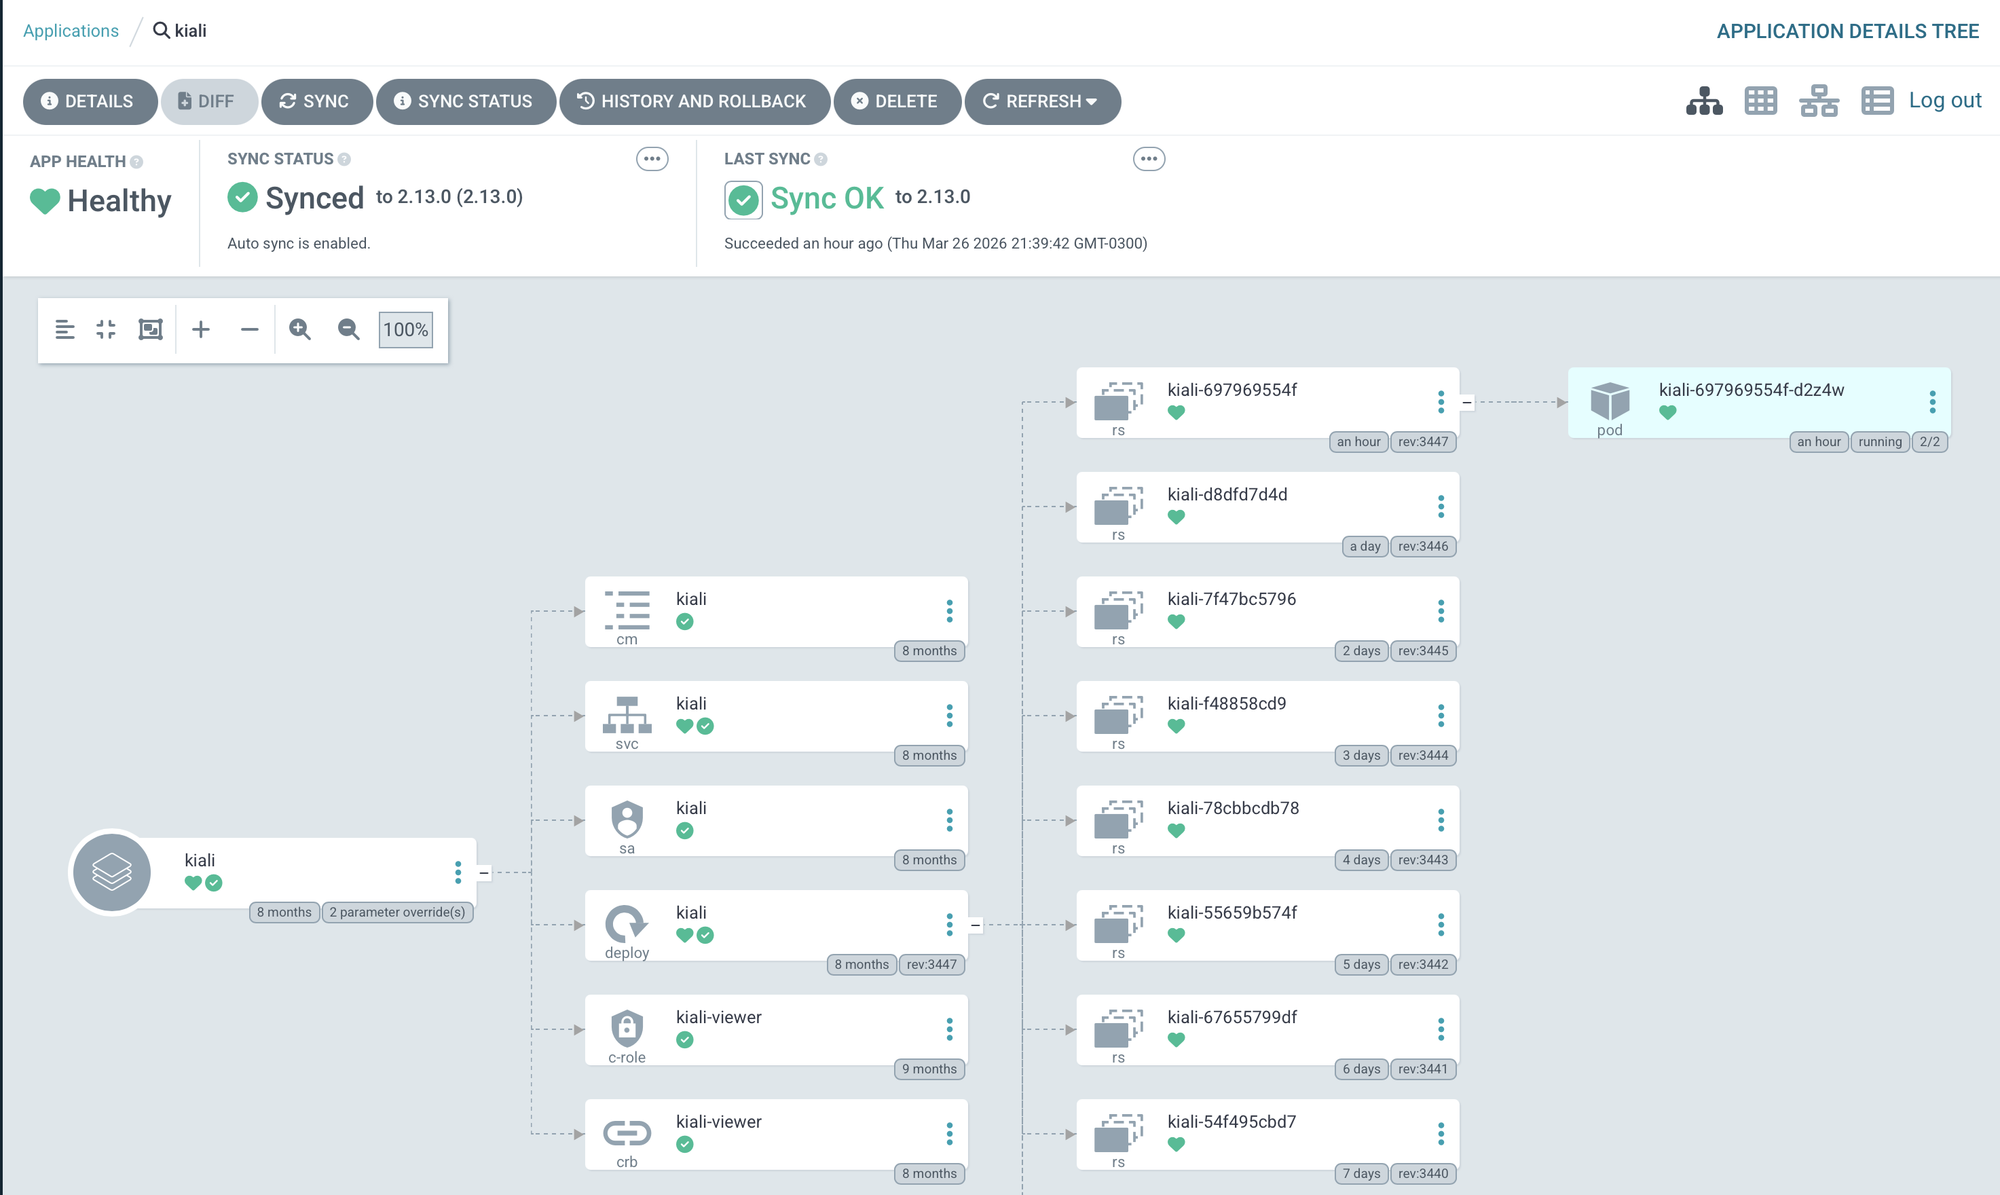
Kiali ficou acessível por meio de um VirtualService gerenciado pelo Istio. As imagens abaixo registram essa primeira fase do ambiente.
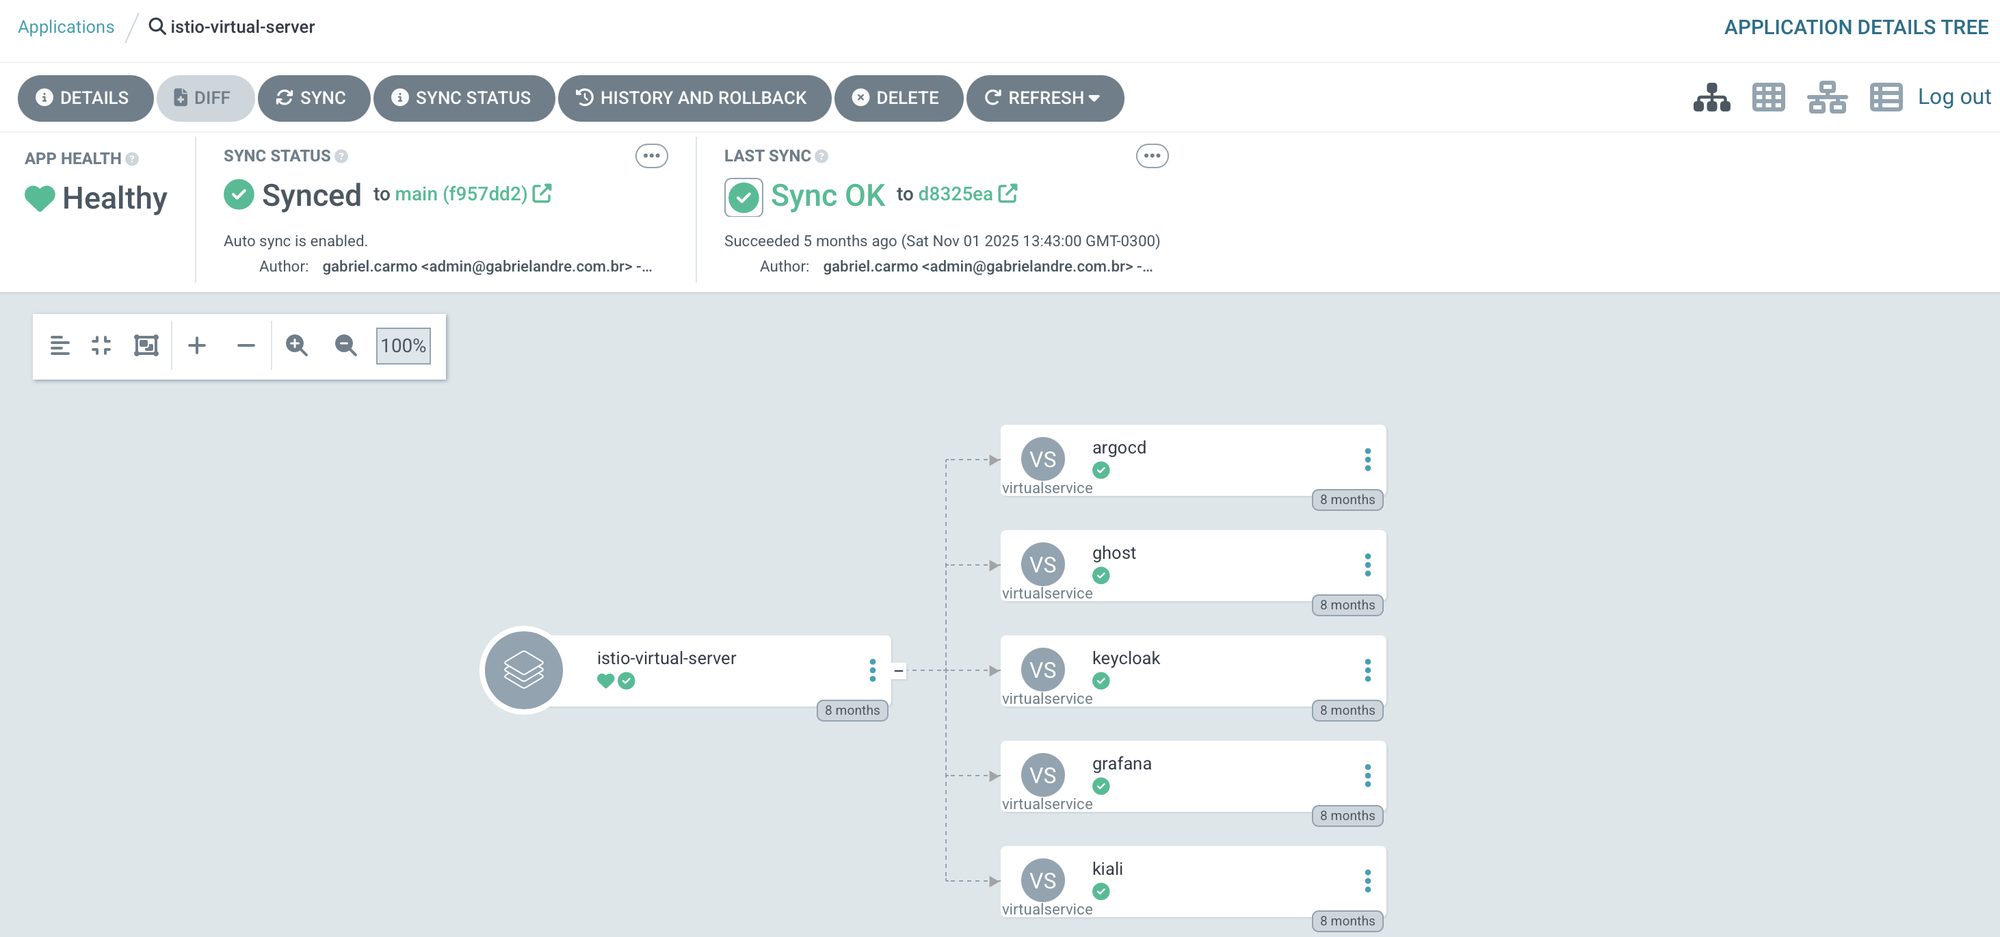
Hora de colocar o fluxo à prova.
Na época em que escrevi esta primeira parte, a instância anterior do Keycloak havia sido perdida e o login do Kiali ainda não funcionava. Era um débito técnico real, daqueles que um HomeLab não deixa esconder por muito tempo.
Sync Waves: dependências ordenadas sem scripts
Alguns componentes dependiam diretamente de outros. Os CRDs do Prometheus precisavam existir antes da stack principal. Istio precisava estar saudável antes das aplicações que utilizavam a malha. Kiali dependia de Prometheus e Grafana. Em vez de scripts complexos de bootstrap, o Argo CD expressava essa ordem com Sync Waves.
annotations:
  argocd.argoproj.io/sync-wave: "1"
A sequência acompanhava naturalmente a cadeia de dependências:
- Wave 0: Grafana, necessário para autenticação e integrações posteriores
- Wave 1: Prometheus e o control plane do Istio
- Wave 5: Kiali, dependente de Prometheus e Grafana
Sem scripts de bootstrap e sem coordenação manual. A anotação de wave fazia o trabalho, mantendo o grafo de dependências nos próprios manifests.
Istio em Ambient Mode: service mesh sem o peso dos sidecars
Uma das decisões mais interessantes foi executar Istio em Ambient Mode, em vez do modelo tradicional baseado em sidecars.
O problema dos sidecars em um cluster pequeno
No Istio clássico, cada pod recebe um Envoy sidecar. Ele intercepta tráfego, aplica mTLS e produz telemetria, mas também consome CPU e memória. Em nós com 2 OCPUs e 12 GB de RAM, esse custo se acumula rapidamente.
Ambient Mode usa outra abordagem. Em vez de um proxy por pod, ele distribui essas responsabilidades entre componentes compartilhados:
- ztunnel: proxy leve executado como DaemonSet em cada nó, responsável por mTLS L4 entre pods
- Istio CNI: plugin que redireciona o tráfego dos pods para o ztunnel sem exigir alterações nas aplicações
O resultado era mTLS automático entre serviços, telemetria L4 e nenhum overhead de sidecar por pod. Recursos L7, como roteamento por headers, retries e circuit breaking, podiam ser adicionados seletivamente com Waypoint Proxies.
A configuração no Argo CD deixava o modo escolhido explícito:
helm:
  values: |
    profile: ambient
    resources:
      requests:
        cpu: 10m
O request de cpu: 10m dizia bastante sobre o objetivo. Em um cluster gratuito e limitado, reduzir o custo fixo da service mesh fazia toda a diferença.
Segurança: TLS, identidade e gerenciamento de Secrets
cert-manager v1.18.1: TLS automático em todos os serviços
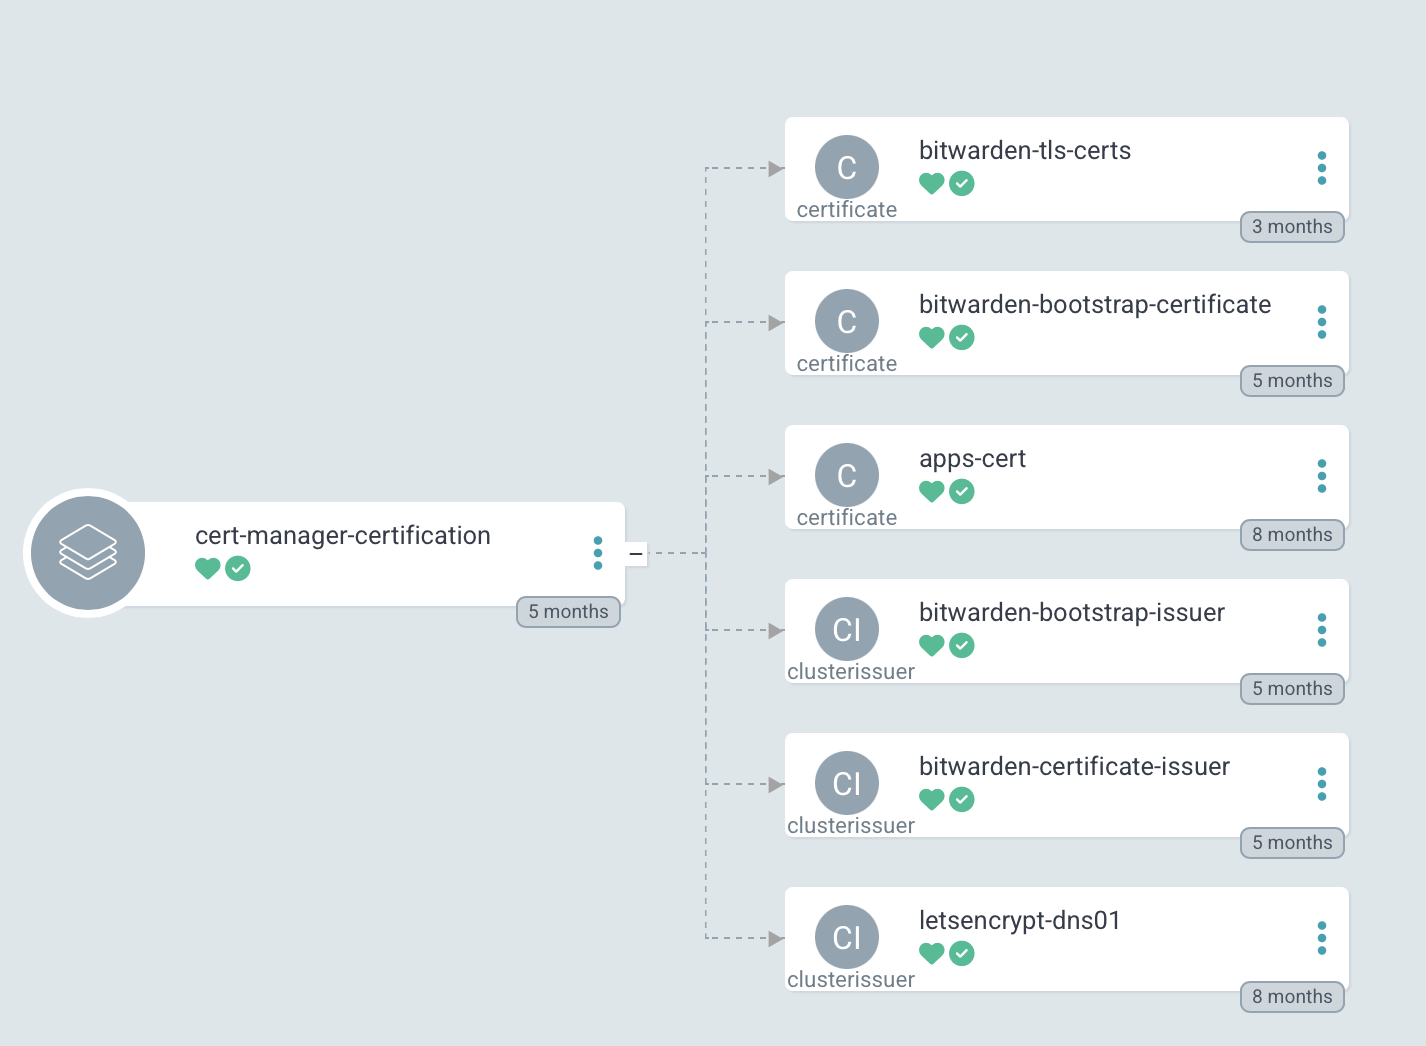
Todo serviço exposto publicamente usava HTTPS. O cert-manager cuidava dos certificados Let’s Encrypt por meio de desafios DNS-01. Essa escolha permitia certificados wildcard e também atendia serviços que não estavam diretamente acessíveis pela internet.
Cloudflare fornecia o DNS. Um ClusterIssuer utilizava credenciais da API injetadas por Secret. Para proteger um novo serviço, bastava declarar um recurso Certificate; validação, emissão e renovação ficavam por conta do cert-manager.
E, naturalmente, tudo também era implantado pelo Argo CD.
Keycloak v26.4: um único provedor de identidade
Keycloak centralizava a identidade do ambiente. Grafana, Kiali, Outline e Argo CD delegavam autenticação via OIDC/OAuth2. Um login, uma base de usuários e um ponto central para administrar acessos.
O chart Helm do Keycloak vinha de um registry OCI, tratado de maneira semelhante a uma imagem de container, com versão explícita e pulls reproduzíveis:
sources:
  - repoURL: oci://registry-1.docker.io/cloudpirates/keycloak
    chart: keycloak
    targetRevision: 0.8.0
Adicionar SSO a um serviço seguia um fluxo consistente: criar um Client no realm, configurar o issuer OIDC na aplicação e deixar o External Secrets injetar o client secret. Nenhuma credencial precisava ser distribuída manualmente.
Naquele momento, parte das aplicações ainda precisava ser reconfigurada para usar o Keycloak. Isso permaneceu como débito técnico e se tornou uma das histórias da evolução descrita na Parte 2.
External Secrets Operator + Bitwarden: nenhum Secret no Git
Nenhuma informação sensível vivia no Git. Credenciais, chaves de API, tokens e certificados ficavam no Bitwarden Secrets Manager e eram sincronizados pelo External Secrets Operator.
O fluxo era direto: o Secret era criado no Bitwarden e associado a um projeto. Um recurso ExternalSecret declarava quais campos buscar e qual Kubernetes Secret materializar. O ESO autenticava por meio de um ClusterSecretStore e entregava o Secret no namespace correto.
É uma configuração que parece trabalhosa no início, mas se torna invisível quando está funcionando. E elimina a preocupação constante de enviar uma credencial para o Git por engano.
apiVersion: external-secrets.io/v1beta1
kind: ClusterSecretStore
spec:
  provider:
    bitwarden:
      organizationId: <bitwarden-org-id>
      projectId: <bitwarden-project-id>
O próprio Argo CD usava um mecanismo complementar, com a sintaxe $secret-name:key, para injetar valores sensíveis em charts Helm durante a sincronização:
helm:
  parameters:
    - name: auth.openid.client_secret
      value: $kiali-secrets:client_secret
O resultado era um repositório que podia permanecer público. As credenciais percorriam Bitwarden → External Secrets → Kubernetes Secret sem parar em arquivos de configuração ou no histórico do Git.
Observabilidade: Prometheus, Grafana e Kiali
kube-prometheus-stack: a fundação
A base de observabilidade era o kube-prometheus-stack, que reunia em um único chart:
- Prometheus: coleta e armazenamento de métricas
- Alertmanager: roteamento e gerenciamento de alertas
- Node Exporter: métricas do sistema operacional dos nós
- kube-state-metrics: métricas dos objetos Kubernetes
- Prometheus Operator: gerenciamento declarativo com ServiceMonitor, PodMonitor e PrometheusRule
Grafana era instalado separadamente, com grafana.enabled: false nos valores da stack. Isso desacoplava seu ciclo de vida e permitia atualizá-lo de forma independente.
Duas opções fáceis de ignorar eram fundamentais para descobrir monitores criados por outros componentes:
serviceMonitorSelectorNilUsesHelmValues: false
podMonitorSelectorNilUsesHelmValues: false
Com essas opções, Prometheus descobria todos os ServiceMonitors e PodMonitors do cluster, independentemente de labels adicionais. Sem elas, métricas importantes, inclusive as do Istio, poderiam ficar de fora.
Essa escolha fazia sentido em um laboratório cujo objetivo era enxergar tudo. Em produção, coletar indiscriminadamente aumentaria cardinalidade e consumo de storage. Restringir os alvos úteis permaneceu como melhoria futura.
Grafana: dashboards persistentes, PostgreSQL e SSO
Grafana rodava em uma Application própria na wave 0, pois Kiali dependia dele.
O backend era PostgreSQL, não SQLite, para preservar dashboards, preferências e sessões entre reinícios e upgrades. A autenticação usava OAuth2 com Keycloak. Prometheus era o datasource padrão, e os dashboards oficiais do Istio eram importados por script, sem copiar JSON manualmente.
Kiali: enxergando a service mesh
Kiali fornecia a visualização da service mesh: topologia, tráfego, saúde dos serviços e inspeção da configuração do Istio em tempo real.
A integração mostrava como as peças se conectavam: credenciais vindas do External Secrets, telemetria coletada pelo Prometheus e autenticação OIDC entregue pelo Keycloak.
helm:
  parameters:
    - name: auth.openid.client_secret
      value: $kiali-secrets:client_secret
    - name: external_services.grafana.auth.token
      value: $kiali-secrets:grafana_token
external_services:
  grafana:
    internal_url: http://grafana.observability.svc.cluster.local:80
    external_url: https://dashboard.gabrielandre.com.br:443
    auth:
      type: bearer
  prometheus:
    url: http://prometheus-kube-prometheus-prometheus.observability.svc.cluster.local:9090
As aplicações
Ghost CMS: o blog pessoal
O blog rodava no Ghost, uma plataforma open source concentrada em escrever e publicar bem, sem transformar a administração do CMS em outro projeto.
Escolhi o Ghost porque ele é open source, pode ser self-hosted, oferece uma experiência de escrita limpa e publica imagens multiarch compatíveis com ARM64.
O deployment utilizava um chart Helm mantido no próprio repositório, com controle sobre recursos e integração com Istio.
Outline: minha base de conhecimento
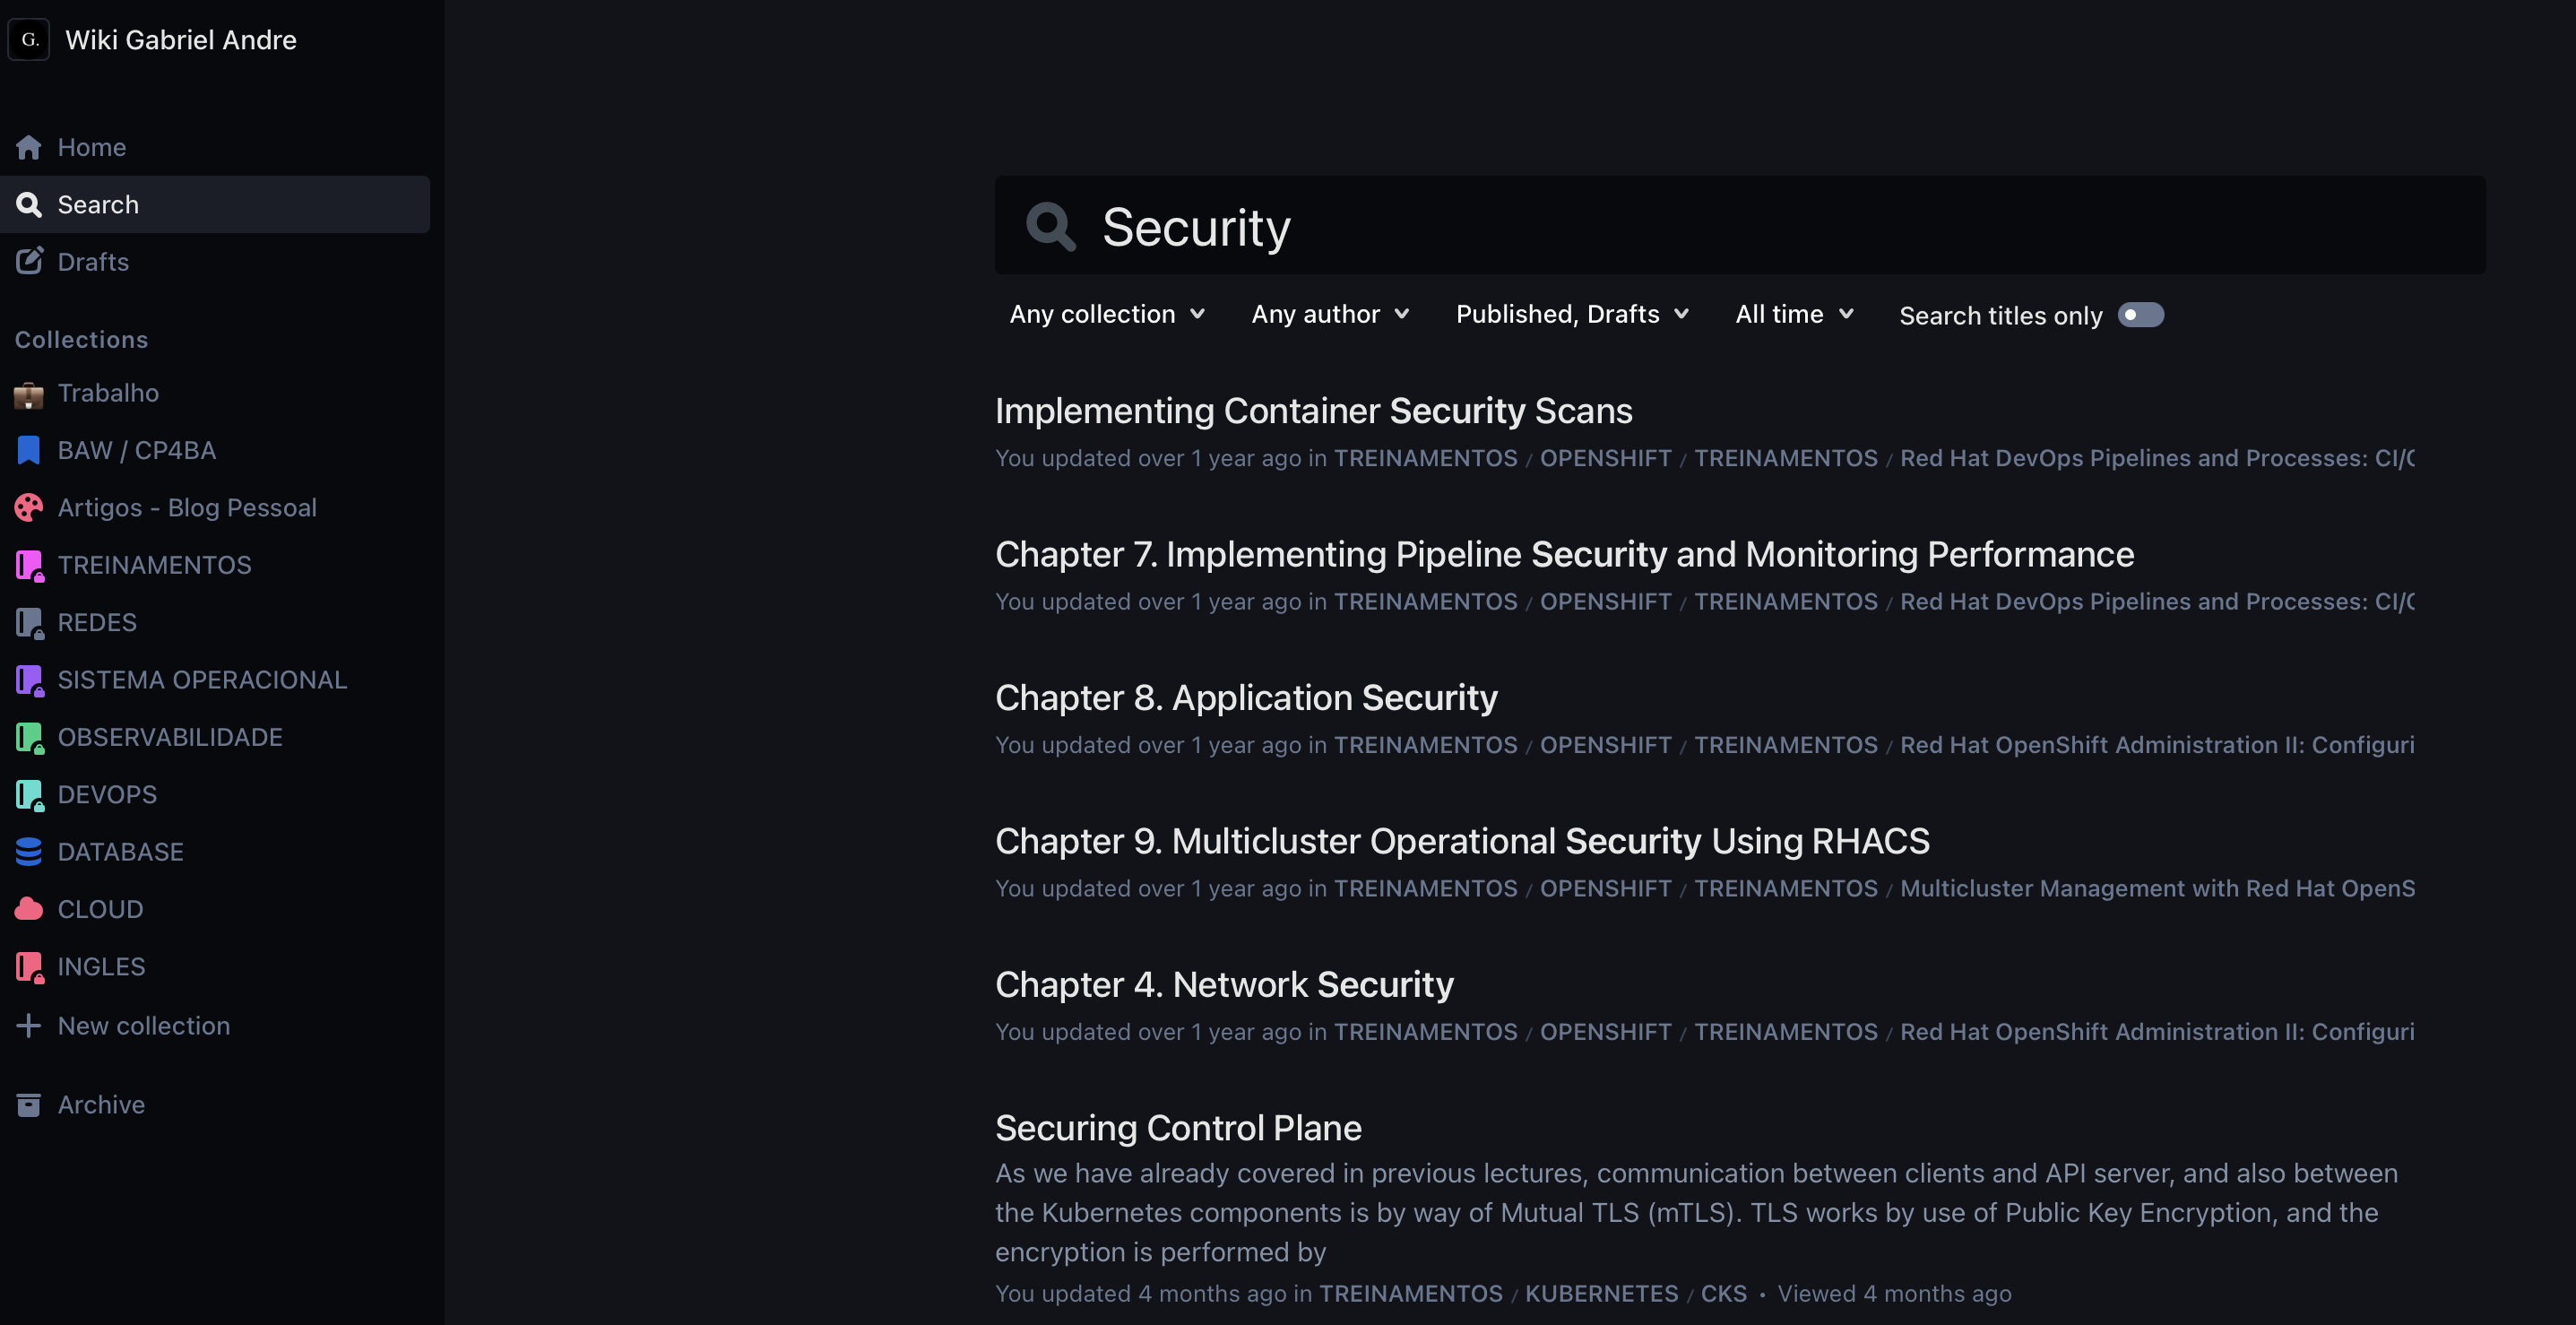
Outline era minha base de conhecimento pessoal: uma alternativa open source e self-hosted ao Notion, com Markdown, coleções, busca e uma interface agradável para escrita.
A wiki em docs.gabrielandre.com.br já reunia mais de 900 documentos sobre Kubernetes, Docker, Podman, Linux, OpenShift, Dynatrace, Zabbix e diversos estudos.
A configuração e a organização desse acervo mereciam um artigo próprio.
Docker Compose havia sido o ponto de partida certo: rápido para implantar e simples para operar. Com o cluster Kubernetes disponível na mesma infraestrutura, migrar o Outline se tornou o próximo passo natural.
Naquele momento, a arquitetura ainda usava Docker Compose na VM da OCI.
Cinco serviços compartilhavam uma rede bridge dedicada, 10.11.0.0/24.
MinIO armazenava arquivos e imagens, substituindo um serviço S3 externo. Durante a inicialização, um script com mc criava o bucket, o usuário da aplicação, a política IAM restrita e o acesso público somente para /public. O storage permanecia reproduzível e sem dependências externas.
PostgreSQL e Redis completavam as dependências do Outline: persistência relacional, sessões, cache e busca.
A estrutura do repositório GitOps
Todo o ambiente era descrito declarativamente em um único repositório. A estrutura modular fazia com que adicionar uma aplicação ou componente seguisse sempre o mesmo padrão.
.
├── argocd/
│ ├── apps/prod/ # Applications do Argo CD organizadas por stack
│ │ ├── cicd/ # Argo CD autogerenciado, GitHub Actions
│ │ ├── istio/ # base, control-plane, ztunnel, cni, ingress
│ │ ├── observability/ # prometheus, grafana, kiali
│ │ ├── security/ # cert-manager, keycloak, external-secrets
│ │ ├── infrastructure/ # namespaces, gateway, virtual servers
│ │ └── app/blog/ # ghost, outline-wiki
│ ├── bootstrap/ # App of Apps per category
│ ├── infrastructure/charts/ # Charts Helm customizados
│ │ ├── namespaces/ # Chart padronizado de namespaces
│ │ ├── ghost/ # Ghost CMS chart
│ │ ├── outline-wiki/ # Outline Wiki chart (with Iframely)
│ │ ├── grafana/ # Grafana values
│ │ └── keycloak/ # Keycloak values
│ ├── projects/ # Projects do Argo CD (RBAC)
│ └── root-apps/ # root-app.yaml (ponto de entrada)
├── scripts/ # Automação em Python e shell
├── Makefile # Interface unificada de comandos
└── readme.md
A separação entre argocd/apps/prod e argocd/infrastructure/charts era intencional. O primeiro diretório declarava o que deveria existir; o segundo descrevia como cada componente seria instalado. Separar intenção de implementação simplificava mudanças futuras.
As stacks cicd, istio, observability, security, infrastructure e app refletiam os limites naturais do ambiente. Cada uma tinha seu próprio bootstrap e podia ser sincronizada ou investigada isoladamente.
Os dez namespaces do cluster
Todos os namespaces eram criados pelo chart namespaces com labels padronizadas. A integração com Istio também era declarada de forma consistente.
| Namespace | Finalidade |
|---|---|
argocd |
Argo CD e ferramentas GitOps |
istio-system |
Istiod (control plane) |
istio-ingress |
Istio Gateway para tráfego externo |
cert-manager |
Gerenciamento de certificados |
keycloak |
Provedor de identidade |
observability |
Prometheus, Grafana, Kiali |
github-runner |
Actions Runner Controller |
blog-pessoal |
Ghost CMS |
outline-wiki |
Outline Wiki + Iframely |
kcsa-prod |
Workloads adicionais de produção |
Automação com Python e Make
Boa parte da operação diária estava codificada em scripts. Python, gerenciado com uv, manipulava YAML; shell cuidava de operações do sistema; e o Makefile oferecia uma interface única. Qualquer sequência repetitiva deveria se transformar em um make <target>.
make add-vs: expondo um serviço
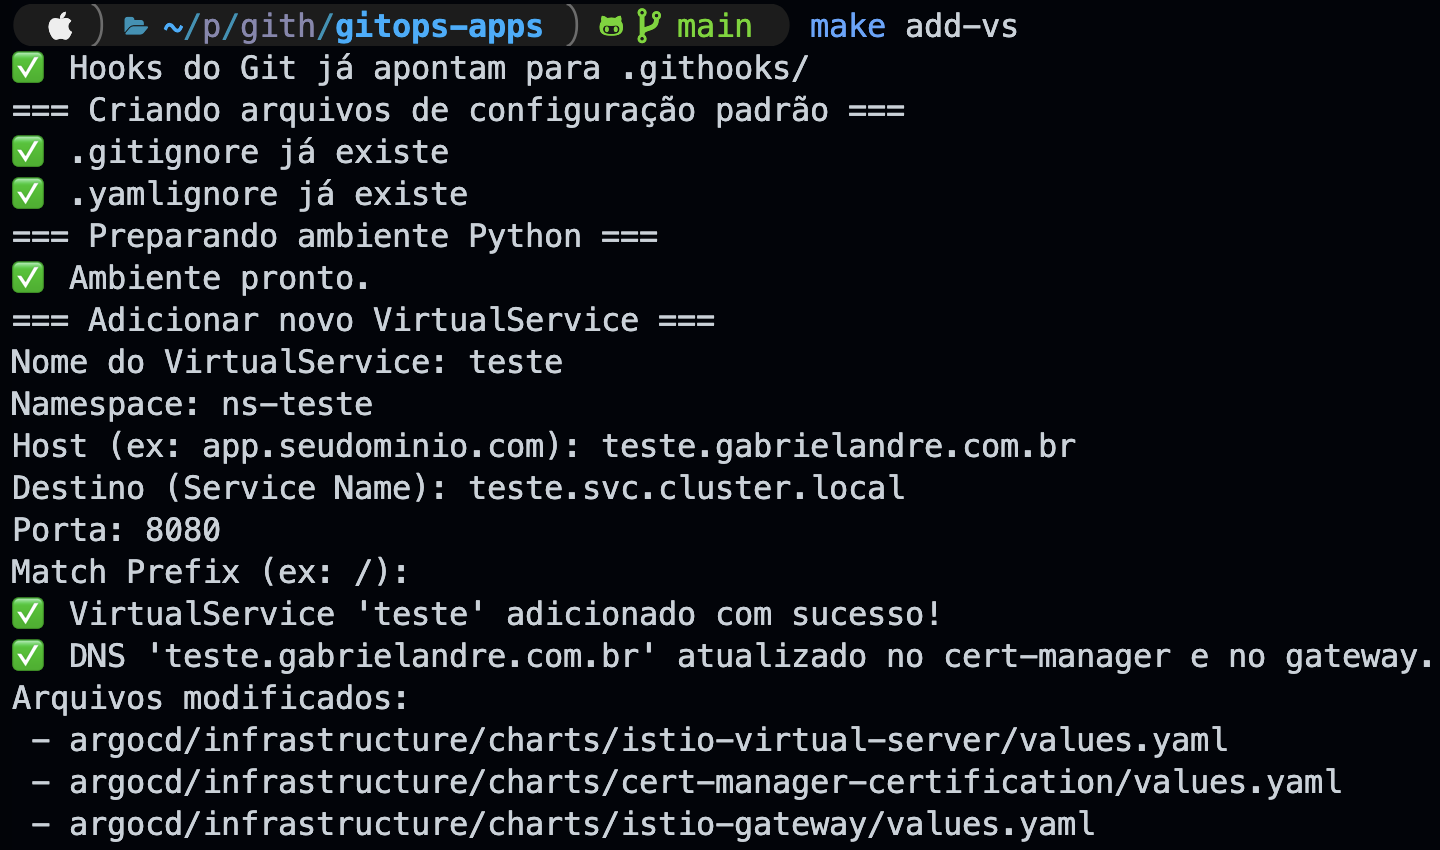
Expor um serviço exigia alterar VirtualService, dnsNames do certificado e hosts do Istio Gateway. Fazer isso manualmente em três arquivos era uma forma eficiente de esquecer alguma coisa.
O add_vs.py atualizava os três pontos de forma atômica com ruamel.yaml, preservando comentários, indentação e estilo. Se o host já existisse, o script parava antes de modificar qualquer arquivo.
No exemplo, um VirtualService chamado teste apontava teste.gabrielandre.com.br para teste.svc.cluster.local na porta 8080. Uma execução, três arquivos atualizados.
make add-namespace: criando namespaces padronizados
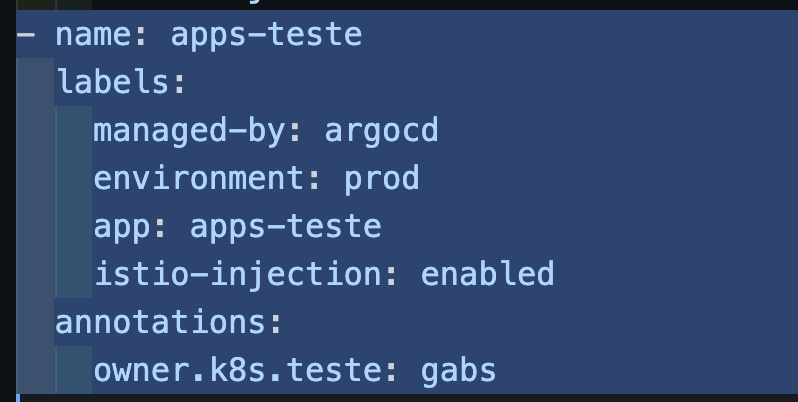
Todos os namespaces viviam em um único values.yaml. O add_namespace.py incluía a nova entrada com nome, ambiente, integração com Istio e anotações opcionais, sem edição manual arriscada.
O fluxo era interativo. No exemplo, o namespace apps-teste foi criado no ambiente prod com Istio habilitado e uma anotação personalizada.
managed-by: argocd
environment: $ENV
app: $NAME_APP
istio-injection: BOOL
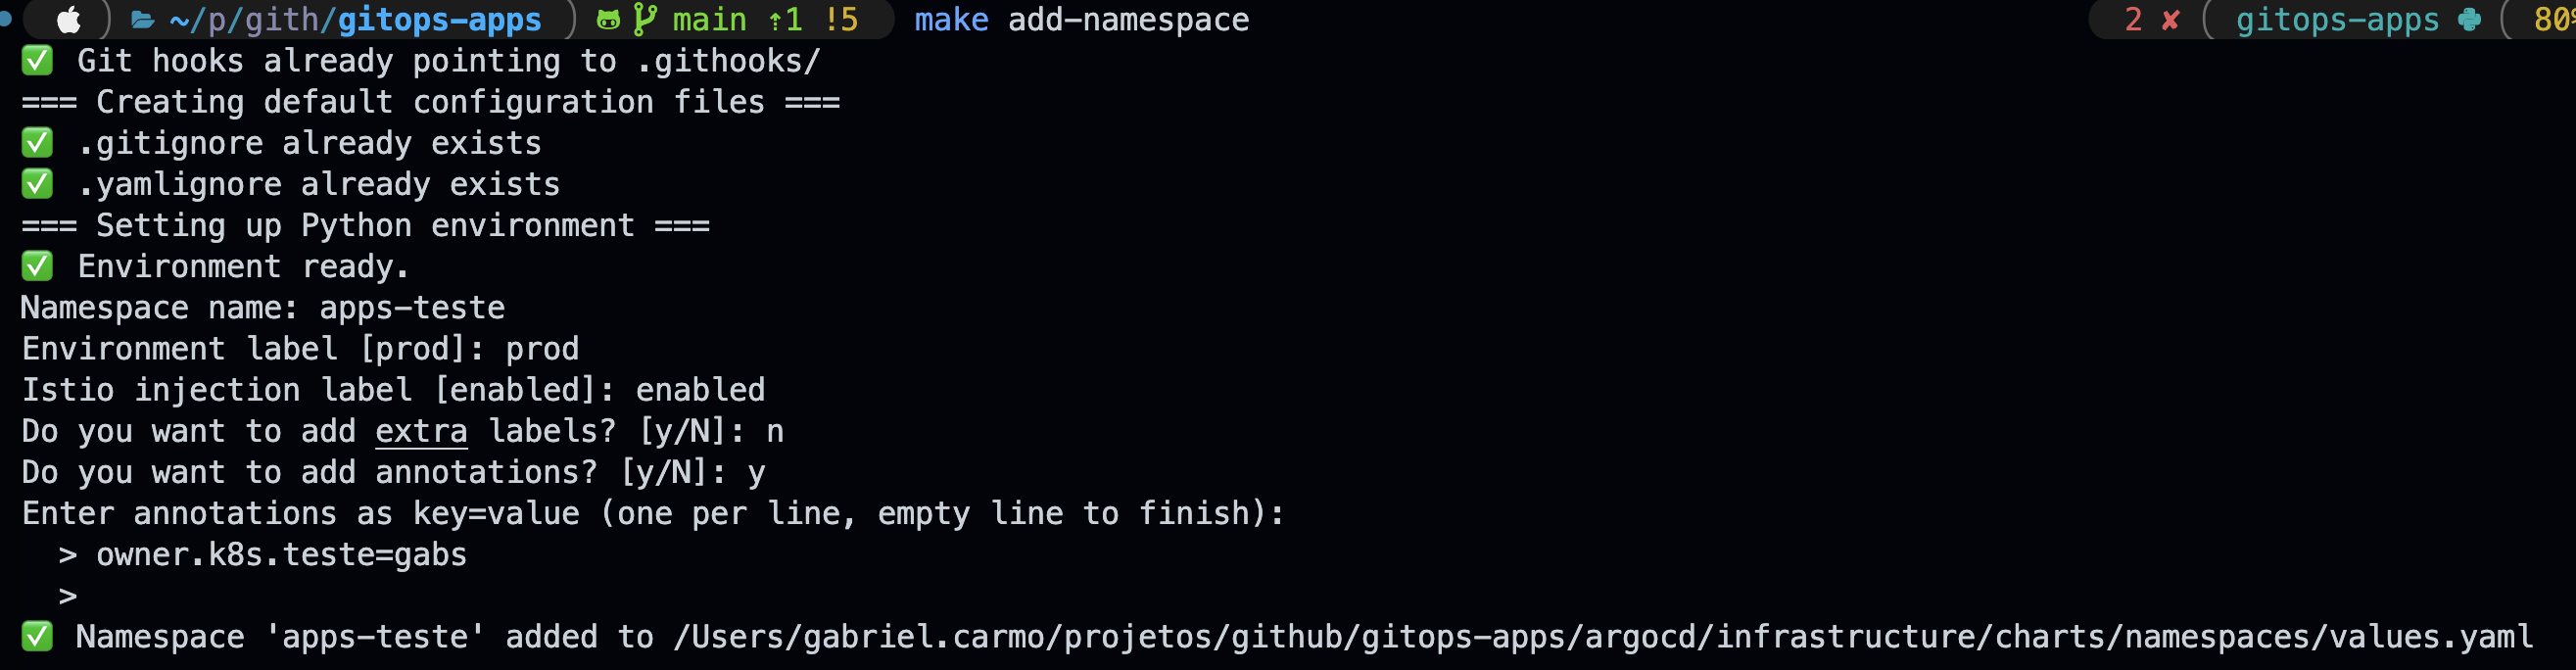
O resultado ia diretamente para o values.yaml do chart. Depois disso, bastava revisar a mudança; o Argo CD cuidava da aplicação.
make create-argo-app: gerando Applications do Argo CD
Escrever uma Application do Argo CD do zero era repetitivo e sujeito a inconsistências. O create_argo_app.py gerava manifests com os padrões do projeto e suportava tanto charts Helm quanto caminhos Git com Kustomize ou manifests puros.
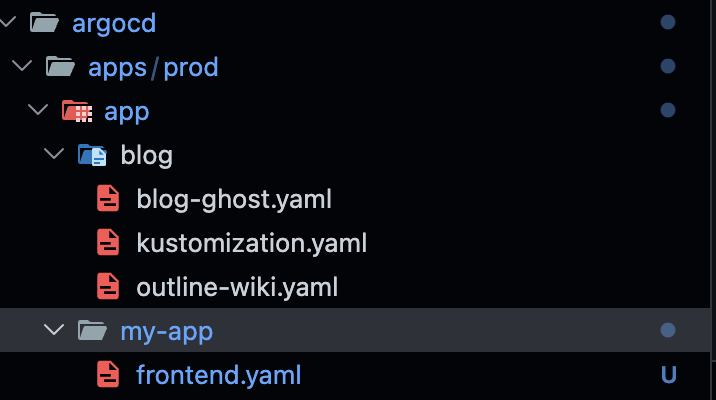
O script solicitava nome, modo da origem, caminho no repositório e arquivo de destino. No exemplo, criou my-app em modo Git path com directory.recurse habilitado.
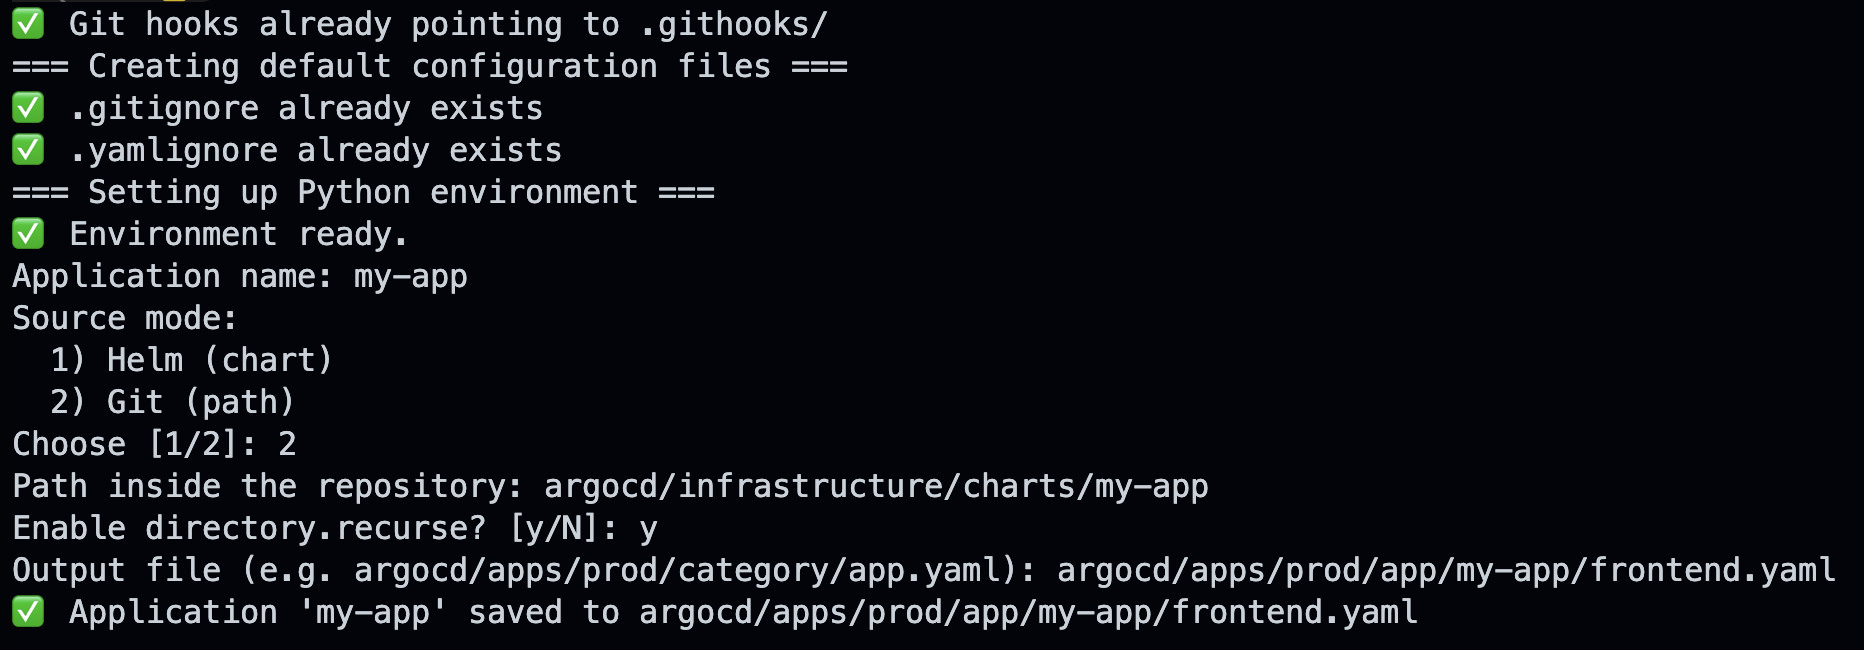
A pasta my-app aparecia no repositório com o manifest pronto para o Argo CD.
make import-istio-dashboards: importando dashboards oficiais
Istio publica dashboards oficiais no Grafana.com. O script consultava as revisões disponíveis, escolhia a compatível com a versão instalada e importava tudo pela API do Grafana.
GRAFANA_TOKEN=glsa_xxx make import-istio-dashboards
GRAFANA_ARGS="--host https://dashboard.gabrielandre.com.br"
O que viria depois
Renovate para atualizar dependências automaticamente
Na época, manter as versões dos componentes ainda dependia de acompanhar releases e lembrar de procurar atualizações. Na prática, isso tornava o processo irregular.
Renovate era a solução óbvia. Ele automatizaria atualizações de charts Helm, imagens, GitHub Actions e manifests Kubernetes. Na Parte 2, essa ideia já havia saído do roadmap e entrado no fluxo real do repositório.
Construir o cluster foi só o começo
O que começou como uma tentativa de evitar custos de nuvem virou um HomeLab com GitOps declarativo, service mesh sem sidecars, identidade centralizada, Secrets fora do Git, observabilidade integrada e automação operacional.
Nada disso foi construído em um fim de semana. O ambiente cresceu devagar, moldado por necessidades reais e pelo que eu estava estudando em cada momento.
A imagem abaixo registra o primeiro commit. O commit mais recente, quando este texto foi escrito, era de 3 de março de 2026.

Nada nasceu pronto. Coisas quebraram, e muitas vezes eu mesmo as quebrei de propósito. Esse sempre foi o objetivo: aprender em um ambiente real sem fingir que ele era infalível.
Ainda havia muito para explorar: Terraform, upgrades do OKE, firewall do load balancer, roteamento no Istio e vários outros detalhes. Eles acabariam alimentando a próxima fase da história.
A história continua: na Parte 2, as falhas e investigações começaram a transformar esse cluster funcional em uma plataforma mais operável.
Links
💡 Quem sou eu?
Sou Gabriel Carmo, CNCF Kubestronaut, com certificações CKA, CKAD, CKS, KCNA e KCSA, além de Red Hat Certified OpenShift Administrator.
Atuo em DevOps Engineering, construindo e evoluindo plataformas Kubernetes multi-cloud. Meu trabalho tem como foco reduzir a carga cognitiva das equipes de engenharia por meio de platform engineering, automação, GitOps e experiências self-service.
No dia a dia, conecto infraestrutura como código, cloud networking, governança, segurança, observabilidade e práticas de SRE para criar plataformas mais padronizadas, resilientes e fáceis de operar.